訛りのある英語の文字起こし:AI精度の実態と格差の真実
Summarize this article with:
率直な現状
2026年のAI文字起こしは、5年前と比べて訛りのある英語をはるかに正確に処理できるようになりました。かつては壊滅的だった格差も多くのアクセントで縮まりましたが、一部のアクセント層では依然として顕著です。本記事では、どこに格差が存在し、なぜそれが起き、どう対処できるのかを詳しく解説します。
「最新AIはすべての英語アクセントに対応できる」という神話
マーケティングでは「モデルの大型化とデータ増加により、誰もが高精度を利用できる」と語られがちです。これは部分的には事実ですが、査読付き研究や独立したベンチマークはより具体的な実態を示しています。
最も多くの記録が残る格差は、AAVE(アフリカ系アメリカ人英語)と標準的な白人アメリカ英語の間にある格差です。 PNASに掲載された2020年のスタンフォード大学の研究(Koeneckeら)では、主要な5つの商用ASRシステムをテストし、黒人話者の単語誤り率(WER)が平均0.35だったのに対し、白人話者は0.19でした。同一タスクにおいて約2倍のエラー率です。自己教師ありモデルを調査した2024年の研究でも、wav2vec 2.0、HuBERT、WavLM、XLS-Rのすべてがこのバイアスを引き継いでおり、音声に含まれるAAVE特有の音韻・形態統語特徴の密度に比例して性能が低下することが確認されました。これらはレガシーシステムではなく、現代のトランスフォーマー世代のモデルです。
AAVEに関する知見は、アクセントの問題が単なる「ノンネイティブ話者」だけの問題ではないことを示しています。強いAAVE音韻を持つネイティブのアメリカ英語話者であっても、主流のアメリカ英語に最適化して学習されたシステムでは測定可能なバイアスに直面します。
現実:アクセントグループごとに大きく異なる精度
ベンダーの宣伝文句ではなく、現在の実証データに基づいた世界各地の英語アクセントの分類は以下の通りです。
学習データの分布に最も近いグループ(最低のWER):
- アメリカ英語(一般アメリカ英語、中西部および太平洋岸北西部の地域方言)
- カナダ英語
- 標準南部イギリス英語(容認発音 / RP)
小さくはあるが有意な格差があるグループ:
- オーストラリア英語およびニュージーランド英語:2024年の研究(GrahamおよびRoll)によると、Whisperにおいてイギリスやオーストラリアのアクセントは、アメリカ英語やカナダ英語と比べて相対WERが約30%高くなりました。あるベンチマークでは、Whisper APIのオーストラリア音声に対するWERは18.21%であり、アメリカ英語音声より大幅に高いエラー率を示しました。
- 教養層のスコットランド英語およびアイルランド英語
- フィリピン英語
精度にばらつきがあり、学習データに依存するグループ:
- インド英語:変動が非常に大きいです。都市部のビジネス層が話す高層変種(acrolect)のインド英語は現在良好に文字起こしできます。一方、地域差(タミル語やベンガル語の影響、地方方言)があるとWERは高止まりします。あるファインチューニング研究では、アクセント特化の適応によりインド訛りの英語のWERが8.6%から7.1%に低下し、格差は実在するものの低減可能であることが示されました。
- ナイジェリアおよび西アフリカ英語全般:学習コーパスに十分に含まれていません。これらの話者を独自の音韻コミュニティではなく漠然と「ノンネイティブ」として分類する研究手法が、モデル開発者から問題を不可視化させ、状況を悪化させてきました。
- シングリッシュおよびシンガポールの口語英語
- 声調言語を第一言語とする強いL2英語(ベトナム語、タイ語、北京語の影響):Whisperの研究では、これらのグループがテスト対象の全アクセントの中で最も大幅な精度低下を経験しました。
- 強い地域性を持つアメリカ英語(アパラチア山脈深部、ルイジアナ・クレオールの影響が残る地方方言など)
私自身の見解: 2024年から2025年にかけての複数の研究における共通の結論は、依然としてアメリカ英語とカナダ英語が基準分布であり、その基準から音響的な距離が離れるほど性能が低下するということです。2025年1月のベンチマークでは、Google Cloud STTが訛りのある音声に最も苦戦した一方、OpenAIのWhisperとAssemblyAIはより良好で、Geminiのマルチモーダルモデルが強い訛りの音声に対して全エンジン中最高の性能を示しました。ツール選定時はこの傾向を参考にしてください。
なぜ格差は完全に解消されないのか
残された格差の大部分は、3つの要因によって説明できます。
学習データが依然として主流のアメリカ英語に偏っていること。 Whisper large-v3は約500万時間の音声(100万時間の弱ラベル付き音声と、以前のモデルによる400万時間の擬似ラベル付き音声)で学習されており、初代Whisperの68万時間から大幅に拡大しました。しかし、ウェブからスクレイピングされた音声は、ネット上にコンテンツを制作・投稿する層の属性を色濃く反映します。総時間数にかかわらず、公開ウェブへの音声発信が少ないコミュニティはデータ内で十分に代表されていません。
音素目録と韻律の違い。 インド英語は強弱リズム(stress-timed)よりも音節リズム(syllable-timed)になる傾向があり、モデルが予測する時間構造がずれます。声調言語を母語とする話者は、第一言語のピッチパターンを英語に持ち込むため、モデルの予測と異なる音響特徴を生み出します。また、一部の方言のようにモデルが区別するよう学習した母音(「pen」と「pin」など)を混同するアクセントでは、予測通りのエラーが一貫して発生します。これらは音韻体系の不一致に起因します。
「ノンネイティブ」という一括ラベルの問題。 学術研究でも指摘されているように、データキュレーションにおいて異なるアクセントコミュニティが単一の「Non-Native English」カテゴリに統合されがちです。このラベルで学習したモデルは、ナイジェリア英語、ベトナム訛りの英語、ハンガリー訛りの英語を区別できません。それぞれの音響的特徴は全く異なります。学習時にそれらを単一の存在として扱うことが、いずれのアクセントに対しても正確なモデル化を難しくしています。
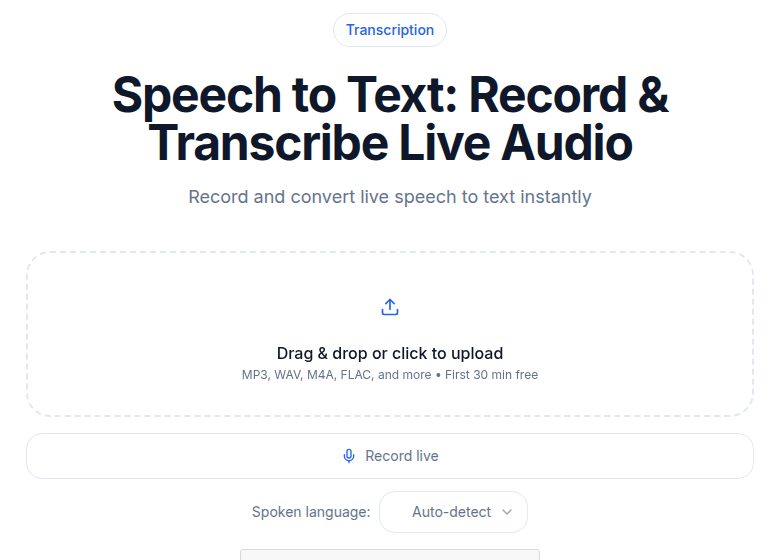 CATT音声テキスト変換ツールのインターフェース
ベンダーが本来伝えるべきこと
ランディングページで目にする「精度98%」という数値は、通常、明瞭なアメリカ英語でのベンチマークから算出されています。大半のベンダーはアクセント別の精度内訳を公開していないため、訛りのある音声でツールを比較するには自身のサンプルでテストするしかありません。
例外はSpeechmaticsで、ユーザーがアクセントパックを選択することなく、あらゆる英語アクセントに対応するよう明示的に設計された「Global English」モデルを公開しています。それが特定のアクセントにおいてエンジン非依存の競合他社を上回るかどうかは、マーケティングページではなく、5分間の実際の音声サンプルで確認すべきです。
ベンダーがこの課題に真剣に取り組んでいる証拠の1つは、モデルが音響コンテキストのみから推測することを期待するのではなく、キーワードバイアスやヒント機能を公開しているかどうかです。
実際に効果のある対策
録音品質には想像以上のレバレッジがある
訛りのある音声の文字起こし精度を向上させる最も確実な方法は、録音環境を改善することです。 あるベンチマークのまとめでは、マイクの価格よりもマイクとの距離のほうが重要であると指摘されています。部屋の反対側の机に置かれた高価な会議用マイクよりも、話者の唇から3〜4インチ(7〜10cm)に構えた手頃な指向性マイクのほうが優れた結果をもたらします。
クリアな音声は、モデルにより多くの有用な信号を提供します。特定のアクセントにおいてモデルがすでに学習分布の境界で動作している場合、ノイズを減らすことで推論に利用できる最良の音響証拠が与えられます。これは、すでにモデルの基準分布に近い話者と比べて、訛りのある話者に不釣り合いなほど大きなメリットをもたらします。
信号品質とWERの相互関係についての詳細は、文字起こし精度の解説記事を参照してください。
キーワードと語彙のバイアス指定
WhisperとDeepgram Nova-3はどちらも、想定される語彙へとモデルを誘導するヒント機能をサポートしています。Deepgram Nova-3は1リクエストにつき最大1,000個のカスタム用語と設定可能な重み付けを受け付けます。AssemblyAIのUniversal-3 Proは、最大1,500語の自然言語によるキーワードプロンプトに対応しています。Whisperは用語集(グロッサリー)プロンプトをサポートしています。
特定の固有名詞、地域用語、専門用語を使用する訛りのある話者の場合、ヒントリストを活用することで、書き起こしで最も重要な単語の精度を取り戻すことができます。たとえばラゴスのフィンテックカンファレンスを文字起こしする場合、「Naira」「fintech」「NITDA」や関連企業名をヒントとして直接指定すれば、デコード開始前にモデルを正しい語彙へと導くことができます。
重要な音声では2つのエンジンを併用する
司法証言録取、ジャーナリズムのインタビュー、学術研究の記録など、一言一句が重要な音声では、同じ音声をWhisper Large-v3とDeepgram Nova-3の両方に通して出力を比較することで、片方のエンジンがミスをしてもう片方が正しく拾ったエラーを検出できます。両エンジンは異なる音響特徴でつまずくため、エラーが完全に重複することは稀です。Nova-3の強みについては、Deepgram Nova-3の解説記事で詳しく取り上げています。
手間は増えますが、AIが確実に処理できる限界線上にある訛りの強い音声に対しては、計算コストをかける価値が十分にあります。
最も困難なケースには人手による確認
AIの処理限界にある音声については、人間による文字起こしが依然として正解です。これはAIの敗北ではなく、現在の機能と用途を正しくマッピングした結果です。率直な比較についてはAIと人間による文字起こしの比較をご覧ください。
実用的な判断基準:サンプルのAI文字起こし結果に対し、音声1時間あたり10〜15分以上の修正が必要な場合は、人間が補助する文字起こしプロセスのほうが全体として高速になる可能性が高いです。
大量運用の特定アクセント向けファインチューニング
特定のアクセントを大量に文字起こしする組織の場合、対象の話者母集団からのラベル付き音声でWhisperベースモデルをファインチューニングすることで、残りの格差の一部を埋めることができます。インド英語の研究では、ターゲット適応によりWERが8.6%から7.1%に改善しました。イギリス地域方言に関する英国政府の研究(Adapting Whisper for Regional Dialects, 2025)でも、グラスゴー訛りやウェールズ英語において、少量のラベル付きデータセットでも同様の改善が得られることが示されています。
ファインチューニングは手軽な解決策ではありません。有意な成果を得るには数百時間のラベル付き音声が必要であり、改善は汎用的なものではなく特定のアクセントに限定されます。しかし、単一地域の母集団に対応するコールセンターや医療機関にとっては適切なアプローチです。
母国語での文字起こしという選択肢
最善の選択肢が「そもそも英語で文字起こししないこと」である場合もあります。母国語のほうが話しやすい話者は、訛りのある英語よりも母国語で話したほうが明瞭な音声を録音できることが多く、母国語で文字起こししたほうが英語の文字起こしよりも精度が高くなる場合があります。
Whisper Large-v3はネイティブで99言語をサポートしています。国際ビジネスで一般的な、話者が英語と他言語を交互に話す多言語録音の場合、最新のエンジンはコードスイッチングに対応できますが、言語の切り替わり目で混乱した出力が生じる可能性があります。用途が許す限り、単一言語での録音を選ぶことでその問題を完全に回避できます。話者がそれらの言語を得意としている場合は、ヒンディー語の文字起こしとコードスイッチングやスペイン語文字起こしガイドを参照してください。
より広範な問題:英語偏重のAI世界における非英語アクセント
ASRにおけるアクセントバイアスは、なぜAIは低リソース言語で苦戦するのかで解説したより大きな問題の一部です。学習データには、これまで録音機器、高速回線、音声をインデックスするプラットフォームにアクセスできた層が反映されています。高品質で安価な文字起こしを最も必要としている話者が、モデルを生み出すデータにおいては最も少なく反映されていることが多いのです。
この悪循環は徐々に崩れ始めています。AfriSpeech-200のようなアフリカ系言語の音声データセット、コミュニティから提供されたコーパス、コールセンターのデータを用いた企業のファインチューニングなどにより、カバレッジは広がりつつあります。しかし、西アフリカ、南アジア、東南アジアで今日英語の文字起こしを必要としているユーザーにとって、その進展は依然として道半ばです。世界平均のベンチマークが自分に当てはまると信じ込むよりも、自身のアクセントにおける現在の正確な実力を把握しておくことが実用的です。
まずは実際の音声で試してみる
ミーティングボットの導入やシート単位の月額契約をせずにクリーンな文字起こしが必要なだけなら、ConvertAudioToTextの無料プランを使用すると、アカウント登録なしで実際の音声を最初の30分間文字起こしできます。さらに無料アカウントを作成すれば、1日最大30ファイル、各30分まで利用可能です。実際の話者母集団のサンプルをアップロードして、出力を確認してみてください。ベンチマークの数値はあなたのアクセントが含まれているとは限らない分布を反映しているため、自身の音声で試すことが実際の精度を測る最良の指標になります。
よくある質問
最新のAI文字起こしはすべての英語アクセントを等しく処理できますか?
いいえ。複数の査読付き研究で持続的な格差が確認されています。アメリカ英語とカナダ英語はすべての主要エンジンで一貫して最も低いWERを記録します。AAVE(アフリカ系アメリカ人英語)話者は、レガシー商用システムで白人アメリカ英語話者の約2倍のWERに直面し、このバイアスは最新の自己教師ありモデルでも続いています。一部のベンチマークにおいて、Whisperにおけるオーストラリア英語やイギリス英語の相対エラー率はアメリカ英語より約30%高くなっています。インド英語や西アフリカ英語は、地域ごとの方言や録音環境によって大きく変動します。
訛りのある英語を最も高精度に文字起こしできるエンジンはどれですか?
対象のアクセントや用途によって異なります。2025年1月のベンチマークでは、強い訛りの音声全体に対してGeminiのマルチモーダルモデルが最も優れたパフォーマンスを示し、アクセントへの堅牢性においてAssemblyAIとWhisperがGoogle Cloud STTやAzureを上回りました。Speechmaticsはあらゆるアクセントに対応するGlobal Englishモデルを明確に打ち出しています。最も確実な方法は、導入前に2〜3種類のエンジンで自身の音声を5分間テストすることです。
アクセントそのものよりも録音品質のほうが重要ですか?
大半のアクセントにおいて、その通りです。録音環境の改善(指向性マイク、静かな部屋、口元の近くでの集音)により、モデルにより多くの有用な音響信号が届きます。あるアクセントに関してモデルが学習分布の境界付近で動作している場合、クリアな音声は音韻の不確実性から回復する助けになります。適切な録音によるWERの改善幅は、特に中程度の難易度において、アクセント自体によるWERの格差を上回ることがよくあります。
カスタムモデルを構築せずに特定のアクセントの精度を向上させることはできますか?
はい、2つの実践的な手法があります。1つ目はキーワードバイアス(keyterm biasing)です。Deepgram Nova-3とAssemblyAIのUniversal-3 Proは、想定される用語をモデルに誘導するカスタム語彙リストを受け付けます。2つ目は、Whisperで代表的な語彙を含む簡潔な初期プロンプトを指定することです。これらの手法は追加の学習を必要とせず、ドメイン固有の専門用語の精度を数パーセント改善できます。大量運用の場合は、対象話者の数百時間のラベル付き音声でのファインチューニングが大きな投資にはなるものの、より持続的な改善をもたらします。
最新のAIモデルでもAAVEのバイアスは依然として問題ですか?
はい。2024年の研究によると、最新の自己教師あり学習モデル(wav2vec 2.0、HuBERT、WavLM、XLS-R)はいずれも、AAVEの音韻的および形態統語的特徴が多い発話ほど高いWERを示しました。2020年のKoeneckeらのPNAS研究で観測された格差(主要な5つの商用システムで黒人話者のWER 0.35に対し白人話者は0.19)は、その後の世代のモデルでも完全には解消されていません。この格差を埋めるために方言固有のデータセットやアノテーションプロトコルを作成する研究が進められていますが、2026年半ば時点でも依然として現実の課題です。
参考資料
- Koenecke, A. et al. "Racial Disparities in Automated Speech Recognition." PNAS, 2020. https://github.com/stanford-policylab/asr-disparities
- Graham, C. and Roll, J. "Evaluating OpenAI's Whisper ASR: Performance analysis across diverse accents and speaker traits." JASA Express Letters, 2024. https://pubs.aip.org/asa/jel/article/4/2/025206/3267247/
- Kerson AI. "Accent Bias in Speech Recognition: Challenges, Impacts, and Solutions." https://kerson.ai/research/accent-bias-in-speech-recognition-challenges-impacts-and-solutions/
- AssemblyAI. "How accurate is speech-to-text in 2026?" https://www.assemblyai.com/blog/how-accurate-speech-to-text
- ISCA Archive. "Self-supervised Speech Representations Still Struggle with African American Vernacular English." Interspeech 2024. https://www.isca-archive.org/interspeech_2024/chang24d_interspeech.html
- Arxiv. "Adapting Whisper for Regional Dialects: Enhancing Public Services for Vulnerable Populations in the United Kingdom." 2025. https://arxiv.org/pdf/2501.08502
- Deepgram. "Speech Recognition Accuracy: Production Metrics." https://deepgram.com/learn/speech-recognition-accuracy-production-metrics
- OpenAI / Hugging Face. "whisper-large-v3 Model Card." https://huggingface.co/openai/whisper-large-v3
- Deepgram Nova-3 Review, Transcribe Blog. "Is It Still the Fastest STT API in 2026?" https://transcriber.talkflowai.com/blog/deepgram-nova-3-review-benchmarks-pricing
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Spotify Podcast Transcript: Free Ways to Get, Copy and Download the Text
Get a Spotify podcast transcript free: when Spotify's own transcript is enough, the YouTube and RSS routes, and how to paste an episode link for text you can copy and download.
Medical Transcription for Clinical Notes: A Practical AI Workflow for Clinicians
Learn how clinicians use AI transcription for clinical notes. A practical CATT workflow for audio upload, speaker labels, summaries, and TXT or DOCX export.