
Precio de Deepgram Nova-3 en 2026: $0.0043/min por lotes, $0.0077 en streaming
Summarize this article with:
Deepgram Nova-3 es un modelo comercial cerrado de voz a texto diseñado para streaming de baja latencia y trabajo por lotes de alto volumen. Cuesta unos $0.0043 por minuto para audio pre-grabado (alrededor de $0.26 por hora) y unos $0.0077 por minuto en streaming, soporta más de 50 idiomas con cambio de código en tiempo real en 10, e incluye prompting de términos clave para vocabulario de dominio. Sus cifras de precisión y latencia son sólidas pero autopublicadas, así que pruébalo con tu propio audio antes de confiar en ellas. Elige Nova-3 para tiempo real y presupuestos de latencia ajustados; elige Whisper cuando necesites código abierto, autoalojamiento o cobertura de 99 idiomas.
Deepgram lanzó Nova-3 en enero de 2025 como sustituto de Nova-2, su anterior modelo insignia de reconocimiento de voz. Ahora impulsa parte de las herramientas de transcripción en tiempo real y de alto rendimiento publicadas en 2025 y 2026. Esta entrada explica qué es Nova-3, cuáles son sus precios y límites reales en 2026, y cómo se compara con el estándar de código abierto, Whisper.
Paso la mayor parte de la semana enrutando audio entre motores de transcripción, así que mi objetivo aquí es la versión que me gustaría que publicaran los proveedores: las cifras que son reales, las que son marketing, y la línea que las separa.
Las cifras destacadas de precisión y latencia son puntos de referencia propios de Deepgram, no independientes, así que trátalas como un punto de partida y prueba con tu propio audio. Elige Nova-3 cuando importen la latencia en tiempo real o la facturación por segundo. Elige Whisper cuando necesites control de código abierto, autoalojamiento o cobertura de idiomas menos comunes.
Arquitectura: qué está realmente documentado
Deepgram no ha publicado el número de parámetros, el número de capas ni la variante específica de transformer que usa Nova-3. Es un modelo comercial cerrado, así que la arquitectura es una caja negra. Lo que la empresa sí documenta públicamente:
- Es un modelo de extremo a extremo. La misma red maneja el modelado acústico, el modelado del lenguaje y la producción final de texto, en lugar de tres etapas separadas.
- Está entrenado con un gran conjunto de datos de audio propietario que incluye audio de llamadas empresariales, podcasts, datos conversacionales y grabaciones ruidosas del mundo real.
- Sirve tanto el modo API en streaming (tiempo real) como el de audio pregrabado desde el mismo modelo subyacente.
- Devuelve marcas de tiempo a nivel de palabra y puntuaciones de confianza directamente.
Deepgram ha optimizado la latencia de inferencia y el coste por minuto, y Nova-3 continúa esa línea. El lanzamiento se centró en la velocidad y la personalización en lugar de la precisión bruta.
Qué cambió respecto a Nova-2
La publicación de lanzamiento de Deepgram para Nova-3 enumera algunas mejoras respecto a Nova-2.
Keyterm prompting. Esta es la función estrella. Puedes pasar hasta 100 términos clave (nombres de empresas, nombres de fármacos, jerga técnica) en el momento de la solicitud y el modelo se sesga hacia ellos, sin necesidad de reentrenar el modelo. Deepgram lo llama la primera personalización de autoservicio de este tipo en un modelo de IA de voz. Para vocabularios específicos de un dominio, es la adición más útil de todas.
Cambio de idioma en tiempo real. Nova-3 puede transcribir audio que alterna entre idiomas a mitad de frase en 10 idiomas (inglés, español, francés, alemán, hindi, ruso, portugués, japonés, italiano y neerlandés) usando el código de idioma multi. Nova-2 gestionaba mal el audio con idiomas mezclados.
Mayor cobertura de idiomas. Nova-3 se lanzó con 36 idiomas compatibles y Deepgram lo amplió a lo largo de 2025 hasta más de 50 según la documentación actual.
Menos alucinaciones en silencios y música. Los modelos antiguos de Deepgram a veces generaban texto durante tramos de solo música o de casi silencio. Nova-3 incluye detección de actividad de voz dentro del pipeline que suprime esos falsos positivos. Nuestro artículo sobre cómo funciona la detección de actividad de voz explica por qué esto importa.
Las afirmaciones de precisión, leídas con honestidad
Cada cifra de precisión que Deepgram publica para Nova-3 proviene de las propias pruebas de Deepgram. No hay un benchmark neutral de terceros detrás de ellas. Esto es lo que la publicación de lanzamiento afirma, mantenido por separado para que nada se mezcle:
- Tasa de error por palabra (WER) en streaming: un 54,2% inferior a la del siguiente mejor competidor, al que Deepgram no menciona. WER medio del 6,84% frente al 14,92% del competidor.
- WER en lote: un 47,4% inferior al del siguiente mejor competidor. WER medio del 5,26% frente a aproximadamente el 10%.
- Frente a Whisper en concreto: Deepgram afirma que Nova-3 fue la preferida en los 7 idiomas probados, alcanzando una preferencia de hasta 8 a 1 en algunos, sobre unas 200 muestras de audio.
La cifra del "54%" es frente a un competidor sin nombre, no frente a Whisper. La comparación con Whisper es la prueba de preferencia de 7 de 7 por separado. Muchos posts de segunda mano fusionan ambas cosas en "un 54% más preciso que Whisper", que no es lo que dijo Deepgram. El WER también depende mucho de la calidad del audio, el acento y el dominio, así que la mediana de un proveedor en su propio conjunto de pruebas no es una garantía sobre tus grabaciones de llamadas.
Para recordar: las cifras de precisión de Nova-3 son afirmaciones reales de un benchmark real, pero es el benchmark del proveedor. El único número que importa para tu proyecto es el que midas con tu propio audio.
Puntos fuertes en uso de producción
Donde Nova-3 se gana su puesto de forma consistente.
Latencia en tiempo real. La API de streaming produce transcripciones con una latencia de extremo a extremo en el rango de 200 a 300 milisegundos en buenas condiciones, comparable a la de Nova-2. Para subtitulado en vivo, asistentes de voz y transcripción de reuniones donde los usuarios ven el texto aparecer mientras alguien habla, aquí es donde Deepgram supera a modelos orientados a lote como Whisper.
Facturación por segundo. Deepgram factura por segundo de audio procesado en lugar de redondear al minuto completo. Con grandes volúmenes de clips cortos, esa diferencia de redondeo es dinero real ahorrado frente a proveedores que redondean hacia arriba.
Rendimiento a escala. La infraestructura de Deepgram está pensada para procesamiento de alto volumen. Equipos que transcriben miles de horas al día reportan un rendimiento estable donde un despliegue autogestionado de un solo inquilino se resentiría.
Keyterm prompting. Pasar una lista breve de términos esperados mejora notablemente la precisión en nombres propios y vocabulario específico del dominio, sin necesidad de reentrenar ni de procesos por lotes. Nuestro artículo sobre corregir nombres mal transcritos explica cuándo merece la pena configurarlo.
Puntuaciones de confianza bien calibradas. Nova-3 devuelve niveles de confianza a nivel de palabra que puedes aprovechar en etapas posteriores. Nuestro artículo sobre puntuaciones de confianza en transcripciones explica cómo usarlas.
Limitaciones conocidas
Dónde Nova-3 se queda corto, dicho sin rodeos.
Es un modelo cerrado. No puedes alojar Nova-3 por tu cuenta, ejecutarlo sin conexión ni ajustarlo con tus propios datos fuera de un contrato empresarial. Para requisitos estrictos de residencia de datos o entornos aislados, un modelo abierto como Whisper es la única vía. Nuestro artículo sobre residencia de datos para transcripción cubre cuándo esa restricción es un bloqueo definitivo.
La cobertura de idiomas va por detrás de Whisper. Nova-3 maneja bien más de 50 idiomas; Whisper soporta unos 99 con calidad variable. Para contenido en idiomas menos comunes, Whisper suele ganar por defecto. Nuestro artículo sobre por qué la IA falla con idiomas de pocos recursos aborda esa brecha.
Sin ventaja clara en el audio más difícil. Con inglés limpio de un solo hablante, Nova-3 y Whisper Large-v3 quedan cerca. En las peores condiciones (acentos marcados, audio telefónico de baja tasa de bits, hablantes superpuestos), la diferencia entre ambos es pequeña y depende del caso de uso. Nuestro análisis de Whisper Large-v3 cubre esa comparación.
Sin rastro de auditoría público. Como la arquitectura y los datos de entrenamiento no son públicos, evaluar sesgos sistemáticos o modos de fallo implica pruebas prácticas, no leer un artículo. Para investigación o usos regulados donde la procedencia del modelo importa, esa opacidad es una limitación real.
La diarización no tiene un límite documentado de hablantes, en ninguna dirección. La diarización de Deepgram detecta hablantes sin que especifiques un número de antemano, y la documentación no publica un máximo. Si has visto una afirmación de "admite hasta 12 hablantes" (incluida en una versión anterior de este mismo post), ese número no aparece en la documentación de Deepgram. Trata el número de hablantes como algo que debes probar con tu propio audio multiparte. Nuestro post sobre cómo gestionar múltiples hablantes en IA cubre lo que la diarización puede y no puede hacer.
Precios en 2026
Estos son los precios de pago por uso publicados por Deepgram para Nova-3. Las cifras cambian, así que confirma en la página de precios de Deepgram antes de basar un presupuesto en ellos.
| Modo | Precio (Nova-3, pago por uso) |
|---|---|
| Pregrabado (batch), monolingüe | Aproximadamente $0.0043 por minuto (~$0.26/hora) |
| Streaming, monolingüe | Aproximadamente $0.0077 por minuto (~$0.46/hora) |
Streaming multilingüe (multi) | Aproximadamente $0.0058 por minuto |
| Crédito gratuito de registro | $200, sin caducidad |
| Plan Growth | Desde unos $4,000 al año, con tarifas con descuento |
Nova-3 pay-as-you-go, 2026.
Dos cosas que el precio por minuto oculta. Primero, Deepgram factura por segundo, así que las cargas de trabajo con clips cortos pagan menos de lo que sugiere la tarifa por minuto. Segundo, el crédito gratuito de $200 cubre cientos de horas de audio en batch, así que puedes evaluar el modelo antes de pagar nada.
Cómo se compara con otras APIs
Es de moda llamar a Deepgram "la opción más barata". En transcripción por lotes en 2026, eso ya no es cierto. Estas son las tarifas base para audio pregrabado, normalizadas por hora, según los precios de cada proveedor.
| Proveedor / modelo | Precio por lote (por hora) |
|---|---|
| AssemblyAI Universal-2 | $0.15 |
| Rev AI Reverb | $0.20 |
| AssemblyAI Universal-3.5 Pro | $0.21 |
| Deepgram Nova-3 | Unos $0.26 |
| OpenAI gpt-4o-transcribe | $0.36 |
| OpenAI gpt-4o-mini-transcribe | $0.18 |
Nova-3 tiene un precio competitivo entre las APIs premium, pero no es el más bajo. El nivel de IA de AssemblyAI y Rev lo superan en tarifas base por lote. Donde Deepgram destaca es en latencia en tiempo real y facturación por segundo, no en el precio de etiqueta. Un matiz que hace que cualquier tabla como esta sea solo un punto de partida: estas son tarifas base de transcripción, y algunos proveedores (AssemblyAI lo indica explícitamente) facturan por separado la diarización de hablantes, la generación de resúmenes y otras funciones de comprensión, así que la tarifa base no es tu factura total.
Para creadores en solitario y equipos pequeños, ninguna de estas APIs por minuto suele ser la compra adecuada de todos modos. Una vez que superas aproximadamente 58 horas de audio al mes, un plan plano ilimitado como CATT Pro por 14,99 US$/mes supera al precio por uso. Nuestra comparativa de precios de transcripción repasa las matemáticas del punto de equilibrio.
Streaming frente a lotes
Nova-3 sirve ambos casos a través de endpoints distintos, y los usos son bien diferentes.
Streaming
El streaming es para cuando el usuario ve la salida mientras se produce: subtítulos en vivo, transcripción de reuniones en tiempo real, entrada de asistentes de voz, herramientas de accesibilidad. La latencia por debajo de 500 milisegundos importa, y la precisión absoluta puede bajar ligeramente porque el modelo suele mostrar correcciones a medida que gana contexto. El streaming de Nova-3 devuelve transcripciones provisionales (mejor estimación, sujetas a revisión) seguidas de transcripciones finales (bloqueadas) conforme llega más audio. La mayoría de las integraciones gestionan el cambio automáticamente.
Lotes
Batch mode is for pre-recorded audio. Latency is seconds for short files and minutes for long ones, and accuracy is higher than streaming because the model has the full audio context. Most standard transcription work, including the uploads on the CATT English transcription tool, is batch. Real-time is common in live captioning workflows and rarer in upload-and-wait tools.
How to decide between Nova-3 and Whisper
A short checklist.
- Real-time latency matters: Nova-3.
- Self-hosted or air-gapped requirement: Whisper.
- 99-language coverage matters: Whisper.
- 50-plus well-supported languages is enough and you want per-second cloud billing: Nova-3.
- Closed-source compliance is acceptable and you want managed infrastructure: Nova-3.
- Open-source compliance is required: Whisper, no contest.
For most production transcription tooling in 2026, the honest answer is "use both and route between them per request." That is what ConvertAudioToText and several tools in the Otter alternatives space do behind the scenes.
Frequently Asked Questions
How much does Deepgram Nova-3 cost per minute?
Nova-3 pre-recorded (batch) transcription runs about $0.0043 per minute, roughly $0.26 per hour, on the pay-as-you-go tier. Streaming runs about $0.0077 per minute, roughly $0.46 per hour. Multilingual streaming is about $0.0058 per minute. Deepgram bills per second of audio, and new accounts get a $200 free credit with no expiration. Prices change, so confirm on Deepgram's pricing page before budgeting.
Is Nova-3 more accurate than Whisper?
On Deepgram's own benchmarks, Nova-3 was preferred over Whisper across all 7 languages they tested, reaching up to an 8-to-1 preference on some. That is Deepgram's test, not an independent one. In practice, on clean single-speaker English the two are close, and on the hardest audio (heavy accents, phone-quality recordings, overlapping speech) the gap is small and depends on your specific audio. The only number that matters is the one you measure yourself.
How many languages does Nova-3 support?
Nova-3 se lanzó en enero de 2025 con 36 idiomas y se amplió a lo largo de 2025 hasta superar los 50, según la documentación actual de Deepgram. El cambio de código en tiempo real, donde el modelo gestiona audio que mezcla idiomas a mitad de transmisión, es compatible con 10 idiomas: inglés, español, francés, alemán, hindi, ruso, portugués, japonés, italiano y neerlandés. Whisper sigue cubriendo más idiomas en total, alrededor de 99, aunque con calidad variable.
¿Puedo autoalojar o ejecutar Nova-3 sin conexión?
No. Nova-3 es un modelo comercial cerrado. No puedes descargarlo, ejecutarlo sin conexión ni ajustarlo con tus propios datos fuera de un contrato empresarial. Si necesitas autoalojamiento, despliegue aislado o control total de los datos, un modelo abierto como Whisper Large-v3 es el camino a seguir.
¿Qué es el prompting por términos clave y realmente ayuda?
El prompting por términos clave te permite pasar hasta 100 términos esperados (nombres de empresas, nombres de productos, jerga médica o legal) junto con una solicitud de transcripción, y Nova-3 se inclina hacia ellos sin necesidad de reentrenamiento. Ayuda sobre todo cuando tu audio está lleno de nombres propios o vocabulario especializado que un modelo general pasaría por alto. Para una lista de nombres comunes, nombres de fármacos o términos técnicos, incluso una lista corta de términos clave mejora notablemente la precisión en esas palabras concretas.
¿Cuántos hablantes puede manejar la diarización de Nova-3?
La diarización de Deepgram detecta hablantes sin que especifiques un número de antemano, y la documentación no publica un máximo. Las afirmaciones de un límite concreto como "hasta 12 hablantes" no aparecen en los documentos de Deepgram. Trata el número de hablantes como algo que debes verificar por tu cuenta en audio multiparte, porque la calidad de la diarización en grabaciones superpuestas o concurridas varía según el motor.
¿Deepgram Nova-3 admite transcripción por streaming en tiempo real?
Sí. Nova-3 ofrece streaming a través de un endpoint WebSocket con una latencia de extremo a extremo de entre 200 y 300 milisegundos en buenas condiciones. Devuelve transcripciones provisionales que pueden revisarse y, después, transcripciones finales que quedan bloqueadas a medida que llega más audio. Este es el caso de uso más fuerte de Nova-3 frente a modelos orientados a lotes como Whisper.
¿Es Nova-3 la API de transcripción más barata?
No en procesamiento por lotes. En 2026, AssemblyAI Universal-2 ($0.15/hora), Rev AI Reverb ($0.20/hora) y AssemblyAI Universal-3.5 Pro ($0.21/hora) están todas por debajo de la tarifa base por lotes de Nova-3, que ronda los $0.26/hora. Nova-3 compite en latencia en tiempo real y facturación por segundo, no en el precio más bajo de la etiqueta. Ten en cuenta que algunos proveedores facturan la diarización y otras funciones por separado, así que las tarifas base no reflejan el coste total.
Por dónde empezar
Si solo necesitas transcripciones, el nivel gratuito de CATT es una opción sin configuración. Para evaluar Nova-3 con tu propio audio, el crédito de autoservicio de $200 de Deepgram cubre cientos de horas de procesamiento por lotes con Nova-3, más que suficiente para compararla con tu flujo de trabajo actual antes de comprometer un presupuesto.
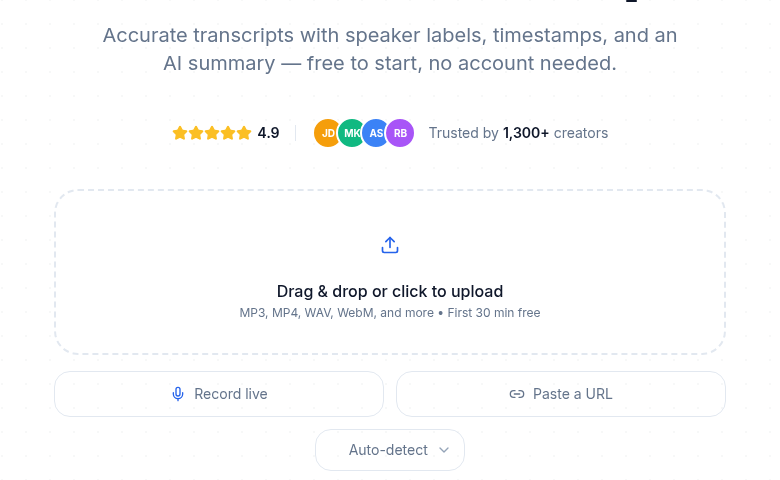 El cargador de ConvertAudioToText: suelta un archivo, graba en directo o pega una URL
Fuentes
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Cómo funciona la transcripción con IA: la cadena de procesamiento explicada (2026)
Desde la subida del archivo hasta la transcripción exportada: un recorrido claro por cada etapa de la cadena de transcripción con IA, incluidos VAD, ASR, diarización, posprocesamiento y exportación.
Modelos de transcripción de código abierto frente a propietarios en 2026
Comparativa honesta entre Whisper de código abierto y las APIs propietarias de Deepgram, AssemblyAI y otras. Costes verificados, rangos de precisión y cuándo tiene sentido cada opción.