
Baja confianza en la transcripción: qué significa y cómo solucionarlo
Summarize this article with:
Una "baja confianza" en una transcripción significa que el sistema de reconocimiento de voz dudó de esas palabras. Cada palabra recibe una puntuación, normalmente entre 0 y 1, según la probabilidad estimada de que sea correcta, y las palabras por debajo de cierto umbral se marcan como de baja confianza. Esta marca es un aviso para comprobar esos puntos con el audio, no una prueba irrefutable de error. El ruido, el solapamiento de voces, los acentos, los nombres poco comunes y los números suelen ser las causas habituales.
Qué significa la "baja confianza en la transcripción", en palabras sencillas
| Lo que ves | Qué significa | Qué hacer |
|---|---|---|
| Pocas palabras con baja confianza | Nombres, números o términos raros que el sistema tuvo que adivinar | Escucha esas palabras y corrígelas |
| Fragmentos enteros con baja confianza | El audio era difícil: ruido, distancia o solapamiento | Revisa el fragmento y mejora la grabación si puedes |
| Baja confianza en todo el archivo | Idioma incorrecto, audio muy deficiente o muchas voces a la vez | Define el idioma hablado manualmente y transcribe de nuevo |
| Alta confianza en todas partes | El sistema estaba seguro, lo que suele indicar un audio claro | Revisa aun así nombres, números y homófonos |
Cómo solucionar una transcripción con baja confianza
- Revisa primero las palabras marcadas. Reproduce el audio en cada punto con baja confianza y corrige lo que escuches. Esto detecta la mayoría de los errores reales en una fracción del tiempo que llevaría una lectura completa.
- Comprueba el idioma hablado. La autodetección puede equivocarse en clips cortos o con varios idiomas. Selecciónalo manualmente y procesa el archivo de nuevo.
- Corrige la grabación, no solo el texto. Si hay secciones enteras con baja confianza, reduce el ruido de fondo, acerca el micrófono y pide a los participantes que no hablen a la vez. Consulta cómo mejorar la calidad del audio antes de transcribir.
- Indica los nombres de los hablantes y los términos. Los nombres poco comunes y la jerga son las palabras con baja confianza más habituales. Corrígelos una vez y busca el mismo error en el resto de la transcripción.
Para ver la lista completa de causas, consulta por qué se cometen errores al transcribir y cómo mejorar la precisión de la transcripción.
Qué significa realmente la puntuación
Una puntuación de confianza es la estimación del motor, expresada como un número entre 0 y 1, de que una palabra específica de la transcripción es correcta. Una puntuación de 0.95 significa que el modelo estima aproximadamente un 95% de probabilidades de haber acertado esa palabra. Una puntuación de 0.42 significa que estaba mucho menos seguro.
En la mayoría de las API de producción, la puntuación se sitúa a nivel de palabra. Deepgram, por ejemplo, devuelve un campo confidence por palabra en cada objeto de palabra en la respuesta de la API, definido en su documentación como "un número de coma flotante entre 0 y 1 que representa la probabilidad estimada por el modelo de que la palabra se haya transcrito correctamente". En la práctica verás valores cercanos a 1.0 en audios limpios, porque con una voz clara el modelo confía plenamente en la mayoría de las palabras. La señal útil está en los valores atípicos.
La salida de referencia de Whisper funciona de otra forma. No muestra la confianza por palabra de forma nativa. En su lugar, cada segmento incluye avg_logprob (probabilidad logarítmica media en todo el segmento, donde un valor más negativo indica menor certeza) y no_speech_prob (la estimación del modelo de que nadie estaba hablando durante ese intervalo). No existe un equivalente directo a la puntuación por palabra de Deepgram sin un posprocesamiento adicional de las probabilidades de los tokens. Las herramientas que envuelven a Whisper pueden derivar estimaciones a nivel de palabra mediante pasos de alineación, pero no son lo mismo que una salida nativa por palabra.
Por qué los números son más difíciles de usar de lo que parecen
Una confianza alta no es una garantía
Una confianza de 0.99 significa que aproximadamente una de cada cien palabras con esa puntuación será incorrecta. En una transcripción de una hora con 8.000 palabras, incluso un 1% de errores con "confianza muy alta" genera unos 80 fallos. El mayor riesgo es que los modelos neuronales modernos pueden mostrar un exceso de confianza sistemático, sobre todo con ruido. Investigaciones publicadas en 2024 y 2025 descubrieron que algunos modelos de ASR predicen erróneamente entre el 10% y el 20% de los tokens con una confianza superior a 0.70 con relaciones señal-ruido bajas. Esto no es un fallo de un único producto; refleja cómo se comportan las probabilidades softmax en los decodificadores neuronales cuando el modelo no ha sido calibrado.
Las palabras con alta confianza son las que se deben revisar en último lugar, pero aun así pueden contener errores.
Una baja confianza no es una sentencia de error
Una palabra con una confianza de 0.45 puede ser perfectamente correcta. Una baja confianza suele indicar que el modelo consideró varias opciones plausibles y eligió una por un margen estrecho. Los nombres propios que el motor rara vez ha visto, los números en los que el contexto admite múltiples valores y los homófonos que solo se aclaran en la siguiente frase son las palabras de baja confianza más habituales. Comprueba esas palabras con el audio en lugar de asumir que están mal.
Las puntuaciones no son comparables entre motores
Un 0.85 de Deepgram y un 0.85 de otro motor no expresan lo mismo. La propia documentación de Deepgram lo afirma con claridad: "Las definiciones y la calibración de la puntuación de confianza varían entre los proveedores de STT. No se pueden comparar directamente las distribuciones de confianza brutas entre proveedores". Cada motor utiliza diferentes escalas de probabilidad, distintos ajustes de calibración y, a veces, definiciones dispares de lo que representa la puntuación. Si eliges entre motores basándote en la confianza media, estás comparando cifras incompatibles.
Una comparación útil entre motores exige probar ambos con el mismo audio, revisar manualmente el resultado y medir la tasa real de error de palabras. Consulta explicación de la precisión en la transcripción para ver cómo hacerlo correctamente.
Nivel de palabra frente a nivel de segmento
La confianza a nivel de palabra asigna un número a cada palabra individual. Es el formato más práctico para revisar transcripciones, ya que permite ir directo a la palabra dudosa.
La confianza a nivel de segmento asigna un único número a un bloque de frase u oración. La puntuación a nivel de transcripción de Deepgram es la mediana de los valores a nivel de palabra de ese fragmento. El avg_logprob de Whisper es una probabilidad logarítmica a nivel de segmento. Ambos sirven para explorar una transcripción larga y localizar los tramos complicados, pero ninguno señala qué palabra dentro del segmento marcado causa el problema.
Para tareas prácticas de revisión, el nivel de palabra es la mejor herramienta. Para tomar decisiones de enrutamiento (enviar este segmento a un revisor humano), el nivel de segmento suele ser suficiente.
Calibración: qué es y por qué importa
Una puntuación de confianza calibrada es aquella en la que el número refleja la precisión de forma honesta. Si reunieras todas las palabras que el motor puntuó con 0.90 y las revisaras todas, exactamente el 90% debería ser correcto. Eso es la calibración. Deepgram describe su confianza por palabra como una "probabilidad calibrada" que tiene esa propiedad como objetivo.
La mayoría de los modelos neuronales no vienen perfectamente calibrados de fábrica. Tienden al exceso de confianza en la parte alta: marcan 0.95 cuando la precisión real ronda el 0.88. El escalado de temperatura y otras técnicas posteriores pueden mejorar esto, pero pocos productos publican si las aplican y cómo lo hacen.
No asumas que el número de confianza es una probabilidad perfectamente exacta. Utilízalo como una señal relativa, no absoluta. Verifícalo con tus propios datos revisando una muestra de palabras en distintas franjas de confianza para ver qué proporción es realmente correcta. La curva de calibración resultante te dirá qué significa cada nivel de confianza en tu tipo de audio concreto. Una entrevista con un acento marcado producirá una curva de calibración diferente a la de un pódcast grabado en estudio, incluso usando el mismo motor.
Cómo usar las puntuaciones de confianza en la práctica
Prioriza la revisión ordenando de menor a mayor
En transcripciones largas, ordena o filtra las palabras por confianza y revisa primero las más bajas. La mayoría de los errores reales en una transcripción de 90 minutos se concentran en unos pocos cientos de palabras por debajo del umbral de 0.70. Revisar esas palabras específicas con el audio detecta la gran mayoría de los errores en una fracción del tiempo que llevaría leer de principio a fin.
La mayoría de herramientas de transcripción de consumo muestran esto resaltando con colores: las palabras de baja confianza aparecen en otro color y puedes ir pasando por ellas con clics. Si trabajas directamente con la API, filtra la lista de palabras por el campo confidence y crea una cola con las marcas de tiempo de esas palabras en tu reproductor de audio.
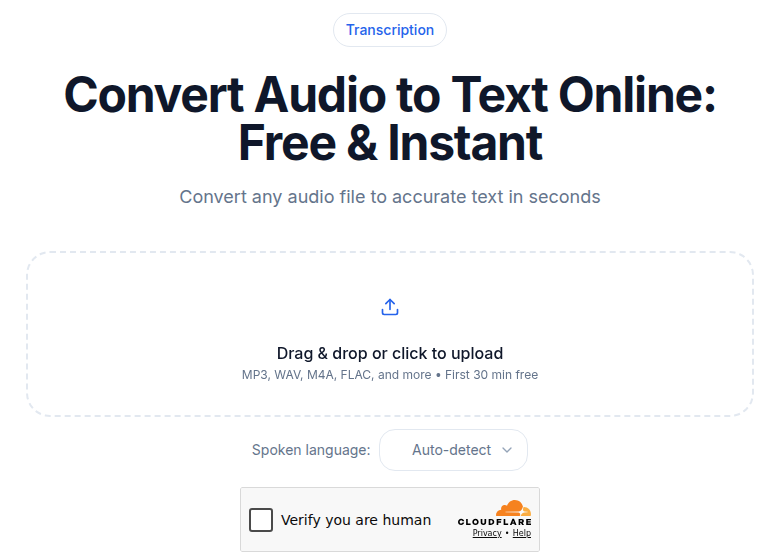 Herramienta de subida de audio en ConvertAudioToText donde comienzan la transcripción y la revisión
Define un umbral para el control de calidad automatizado
En flujos de trabajo de gran volumen o sujetos a normativas estrictas, define un umbral y marca automáticamente para revisión humana las transcripciones o palabras que queden por debajo. Un punto de partida habitual es 0.80 o 0.85, pero la cifra adecuada depende de lo que muestre tu prueba de calibración para tu tipo de audio.
La señal de incertidumbre del modelo se convierte en un filtro de calidad integrado. Esto funciona muy bien en cualquier flujo donde la calidad de la transcripción deba cumplir un estándar definido antes de pasar el texto a otros sistemas. Para más información sobre qué hace que una transcripción cueste menos produciendo calidad, los artículos sobre precios detallan lo que pagas realmente cuando la revisión basada en confianza ya viene incluida.
Pondera las coincidencias de baja confianza en sistemas posteriores
Si vas a crear funciones de búsqueda o analítica sobre las transcripciones, trata el texto como una señal con ruido y no como una verdad absoluta. La coincidencia de una palabra clave con una puntuación de 0.45 debería tener menos peso que una con 0.98. Un panel de analítica que cuente apariciones de términos debería contemplar la ponderación por confianza. De lo contrario, un solo nombre propio mal interpretado puede propagar datos engañosos en los sistemas posteriores.
Lo que la confianza no detecta
Conocer las limitaciones es tan importante como conocer los casos de uso.
La confianza no detecta palabras incorrectas que encajan semánticamente. En inglés, pares como "affect" y "effect", "principal" y "principle" o "your" y "you're" suelen transcribirse con alta confianza porque el motor eligió uno antes de disponer del contexto para distinguirlos. Son errores reales que la puntuación no marcará.
La confianza no detecta alucinaciones durante los silencios. Si el modelo genera texto fantasma durante un tramo de silencio, la confianza de esas palabras inventadas puede ser moderada, pero el texto es totalmente falso. Se trata de un modo de fallo independiente con sus propias señales de detección, ajeno al campo de confianza de la palabra.
La confianza no cubre la precisión de las etiquetas de hablante. La confianza de transcripción evalúa las palabras. Deepgram también incluye un campo speaker_confidence en audios pregrabados para los resultados de diarización, pero es una cifra independiente de un modelo distinto. Ambas señales son autónomas. Una palabra puede estar bien transcrita pero atribuida al hablante equivocado, y ningún campo de confianza lo advertirá. Consulta explicación de la diarización de hablantes para saber cómo funciona la confianza del hablante.
La confianza no detecta palabras omitidas. Si el modelo no transcribió una palabra en absoluto, no existe ninguna puntuación de confianza para señalarlo. Las palabras omitidas son los errores más difíciles de detectar a posteriori y quedan fuera de lo que aborda la puntuación de confianza.
La confianza según el motor: Deepgram y Whisper cara a cara
| Señal | Deepgram | Whisper (referencia) |
|---|---|---|
| Confianza por palabra | Sí, campo confidence (0-1) | No disponible de forma nativa en la API |
| Señal a nivel de segmento | Confianza de transcripción = mediana de las puntuaciones por palabra | avg_logprob (float negativo, más negativo = menor certeza) |
| Detección de silencios | no_speech_prob no está en la salida estándar | no_speech_prob por segmento |
| Confianza del hablante | speaker_confidence (solo pregrabado) | No disponible |
| Listo para flujos con umbrales | Sí, no requiere posprocesamiento | Requiere herramientas de alineación extra para nivel de palabra |
Para quienes quieran implementar una revisión basada en confianza o ponderación posterior, el formato de Deepgram resulta más práctico de inmediato. El avg_logprob de Whisper sirve para decisiones de enrutamiento (marcar un segmento completo), pero necesita herramientas adicionales para calcular valores por palabra. Consulta explicación de Deepgram Nova-3 para conocer más a fondo cómo funciona el motor de Deepgram.
Mi recomendación: lo más útil que puedes hacer con las puntuaciones de confianza es realizar una prueba de calibración con una muestra de tu propio audio antes de diseñar cualquier flujo automático con umbrales. Lo que significa un 0.80 en tu material no es lo mismo que en el de otra persona, y la curva varía según las condiciones del audio.
Preguntas frecuentes
¿Qué significa una baja confianza en la transcripción?
Significa que el sistema de reconocimiento de voz no estaba seguro de esas palabras. Cada palabra recibe una puntuación, normalmente entre 0 y 1, de la probabilidad de que sea correcta. La baja confianza marca palabras o fragmentos con mayor probabilidad de error, a menudo por ruido, solapamiento de voces, acentos, nombres raros o números. Es un aviso para revisar el audio, no una prueba de error.
¿Cómo soluciono una transcripción con baja confianza?
Reproduce el audio en los puntos marcados y corrige las palabras manualmente. Si hay secciones enteras con baja confianza, el problema es la grabación: reduce el ruido de fondo, acerca el micrófono, graba a un solo interlocutor a la vez o define el idioma hablado tú mismo en vez de depender de la autodetección y vuelve a transcribir.
¿Afecta la calidad del audio a la precisión de la transcripción?
Sí, más que cualquier otra cosa. El ruido de fondo, el eco, la distancia al micrófono, el audio telefónico de baja tasa de bits y las personas hablando a la vez reducen la precisión y bajan las puntuaciones de confianza.
¿Qué es una buena puntuación de confianza en la transcripción?
No existe un umbral universal porque las escalas de confianza varían según el motor. En un mismo motor, conviene revisar las palabras por debajo de 0.80. Las palabras por debajo de 0.60 casi siempre merecen revisión. Pero estos cortes son referencias iniciales, no garantías: una palabra con 0.99 puede ser incorrecta y una con 0.55 puede ser correcta.
¿Son comparables las puntuaciones de confianza entre Deepgram, Whisper y otros motores?
No. La documentación de Deepgram indica explícitamente que las definiciones y la calibración de la confianza varían entre proveedores y que las puntuaciones brutas no se pueden comparar directamente. Un 0.85 de Deepgram y un 0.85 de otro motor no expresan lo mismo sobre la precisión.
¿Por qué a veces una palabra con alta confianza resulta ser incorrecta?
El modelo asigna una palabra token por token, antes de disponer del contexto completo. Palabras acústicamente similares ('affect' frente a 'effect', 'principal' frente a 'principle') pueden tener alta confianza porque el modelo nunca las consideró ambiguas, aunque eligiera la incorrecta. El exceso de confianza con ruido también está bien documentado en la investigación de ASR.
¿Una puntuación de baja confianza significa que la palabra es incorrecta?
No necesariamente. La baja confianza indica que el modelo consideró varios candidatos plausibles y el elegido ganó por un margen estrecho. El ganador aún puede ser correcto. Las palabras de baja confianza más comunes son nombres propios, números y homófonos en los que el contexto circundante no bastó para definir un ganador claro.
Para comprobar tus propias grabaciones, la herramienta de audio a texto de ConvertAudioToText transcribe los primeros 30 minutos de un archivo sin necesidad de cuenta, con marcas de tiempo que puedes usar para saltar a los pasajes dudosos del audio.
Fuentes
- Documentación de confianza de Deepgram: definición, afirmación de calibración y advertencia entre proveedores, consultado el 14-10-2026
- Documentación de diarización de Deepgram - campo
speaker_confidenceen salida pregrabada, consultado el 02-07-2026 - Campos verbose_json de OpenAI Whisper - confirmación de
avg_logprobyno_speech_proba nivel de segmento, sin confianza nativa por palabra, consultado el 02-07-2026 - Evaluación de puntuaciones de confianza en ASR, arXiv 2503.15124 - detección automatizada de errores mediante confianza, 2025
- Artículo de ICLR 2024 sobre calibración de confianza en ASR - comportamiento de sobreconfianza en modelos neuronales
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Por qué la IA falla con las lenguas de bajos recursos: una mirada honesta en 2026
La escasez de datos de entrenamiento, la complejidad tonal y la falta de referencias explican la brecha de precisión en la transcripción de lenguas de bajos recursos. Este es el estado real en 2026 y lo que está mejorando.
Transcribir audio de mala calidad: qué se puede salvar (2026)
Guía realista para transcribir audio degradado: cintas de casete, llamadas en altavoz, micrófonos lejanos.
Precisión de transcripción explicada: qué significa realmente el 99%
Qué significa en realidad una precisión de transcripción del 95%: las matemáticas del WER, los trucos de los benchmarks y el tiempo de edición detrás de cada nivel de precisión.
Mejora la calidad del audio antes de transcribir: qué funciona
La cadena de procesamiento previa a la subida que ayuda (mono, normalizar, reducir ruido) y los pasos que te hacen perder el tiempo, siendo honestos.