
Preços do Deepgram Nova-3 em 2026: $0,0043/min em lote, $0,0077 em streaming
Summarize this article with:
O Deepgram Nova-3 é um modelo comercial fechado de fala para texto, feito para streaming de baixa latência e trabalho em lote de alto volume. Custa cerca de $0,0043 por minuto para áudio pré-gravado (em torno de $0,26 por hora) e cerca de $0,0077 por minuto em streaming, suporta mais de 50 idiomas com troca de código em tempo real em 10, e traz keyterm prompting para vocabulário de domínio. Os números de precisão e latência são fortes, mas publicados pela própria empresa, então teste no seu próprio áudio antes de confiar. Escolha o Nova-3 para tempo real e orçamentos de latência apertados; escolha o Whisper quando precisar de código aberto, auto-hospedagem ou cobertura de 99 idiomas.
A Deepgram lançou o Nova-3 em janeiro de 2025 como substituto do Nova-2, seu modelo de reconhecimento de fala anterior e principal. Ele agora alimenta parte das ferramentas de transcrição em tempo real e de alto rendimento lançadas em 2025 e 2026. Este post explica o que é o Nova-3, quais são seus preços e limites reais em 2026, e como ele se compara ao padrão open-source, o Whisper.
Passo a maior parte da semana roteando áudio entre mecanismos de transcrição, então meu objetivo aqui é a versão que eu gostaria que os fornecedores publicassem: os números que são reais, os que são marketing, e a linha entre eles.
Os números de precisão e latência no título são benchmarks da própria Deepgram, não independentes, então trate-os como um ponto de partida e teste no seu áudio. Escolha o Nova-3 quando latência em tempo real ou cobrança por segundo importar. Escolha o Whisper quando precisar de controle open-source, auto-hospedagem, ou cobertura de idiomas menos comuns.
Arquitetura: o que está realmente documentado
A Deepgram não publicou contagens de parâmetros, contagens de camadas, ou a variante específica de transformer que o Nova-3 usa. É um modelo comercial fechado, então a arquitetura é uma caixa preta. O que a empresa documenta publicamente:
- É um modelo ponta a ponta. A mesma rede lida com modelagem acústica, modelagem de linguagem, e produção final de texto, em vez de três estágios separados.
- É treinado em um grande conjunto de dados de áudio proprietário, cobrindo áudio de call centers empresariais, podcasts, dados conversacionais, e gravações ruidosas do mundo real.
- Ele atende tanto aos modos de API de streaming (tempo real) quanto de pré-gravado a partir do mesmo modelo subjacente.
- Ele retorna timestamps em nível de palavra e pontuações de confiança diretamente.
A Deepgram tem otimizado para latência de inferência e custo por minuto, e o Nova-3 continua isso. O lançamento focou em velocidade e personalização em vez de precisão bruta.
O que mudou em relação ao Nova-2
O post de lançamento da Deepgram para o Nova-3 lista algumas melhorias em relação ao Nova-2.
Keyterm prompting. Esse é o recurso principal. Você pode passar até 100 termos-chave (nomes de empresas, nomes de medicamentos, jargão técnico) no momento da requisição e o modelo tende a priorizá-los, sem precisar de re-treinamento. A Deepgram chama isso de a primeira personalização self-service do tipo em um modelo de voz com IA. Para vocabulários específicos de domínio, essa é a adição mais útil.
Code-switching em tempo real. O Nova-3 consegue transcrever áudio que alterna entre idiomas no meio da frase em 10 idiomas (inglês, espanhol, francês, alemão, hindi, russo, português, japonês, italiano e holandês) usando o código de idioma multi. O Nova-2 lidava mal com áudio misto.
Cobertura de idiomas mais ampla. O Nova-3 foi lançado com 36 idiomas suportados e a Deepgram expandiu isso ao longo de 2025 para mais de 50, conforme a documentação atual.
Menos alucinações em silêncio e música. Modelos antigos da Deepgram às vezes geravam texto durante trechos só com música ou quase silenciosos. O Nova-3 inclui detecção de atividade de voz dentro do pipeline que suprime esses falsos positivos. Nosso post sobre como funciona a detecção de atividade de voz explica por que isso importa.
As alegações de precisão, lidas com honestidade
Todo número de precisão que a Deepgram publica para o Nova-3 vem dos próprios testes da Deepgram. Não há um benchmark neutro de terceiros por trás deles. Aqui está o que o post de lançamento alega, mantido separado para que nada seja confundido:
- Taxa de erro por palavra em streaming (WER): 54,2% menor que a do concorrente mais próximo, que a Deepgram não revela. WER mediano de 6,84% contra 14,92% do concorrente.
- WER em lote: 47,4% menor que a do concorrente mais próximo. WER mediano de 5,26% contra cerca de 10%.
- Comparado especificamente ao Whisper: a Deepgram afirma que o Nova-3 foi preferido em 7 de 7 idiomas testados, chegando a uma preferência de 8 para 1 em alguns casos, em cerca de 200 amostras de áudio.
O número de "54%" é contra um concorrente não identificado, não contra o Whisper. A comparação com o Whisper é o teste separado de preferência de 7 em 7. Muitos posts de segunda mão misturam os dois e viram "54% mais preciso que o Whisper", o que não foi o que a Deepgram disse. O WER também depende muito da qualidade do áudio, do sotaque e do domínio, então a mediana de um fornecedor no próprio conjunto de testes não é uma promessa sobre suas gravações de chamadas.
Para lembrar: os números de precisão do Nova-3 são afirmações reais de um benchmark real, mas é o benchmark do fornecedor. O único número que importa para o seu projeto é aquele que você mede no seu próprio áudio.
Pontos fortes no uso em produção
Onde o Nova-3 realmente mostra seu valor.
Latência em tempo real. A API de streaming produz transcrições com latência de ponta a ponta na faixa de 200 a 300 milissegundos em boas condições, comparável ao Nova-2. Para legendagem ao vivo, assistentes de voz e transcrição de reuniões onde os usuários veem o texto aparecer enquanto alguém fala, é aqui que a Deepgram se destaca de modelos focados em lote como o Whisper.
Cobrança por segundo. A Deepgram cobra por segundo de áudio processado, em vez de arredondar para o minuto inteiro. Em grandes volumes de clipes curtos, essa diferença de arredondamento é dinheiro de verdade economizado em comparação com provedores que arredondam para cima.
Throughput em escala. A infraestrutura da Deepgram é feita para processamento de alto volume. Equipes que transcrevem milhares de horas por dia relatam throughput estável, onde uma implantação self-hosted de locatário único sofreria.
Keyterm prompting. Passar uma lista curta de termos esperados melhora visivelmente a precisão em nomes próprios e vocabulário de domínio, sem retreinamento e sem job em lote. Nosso post sobre corrigindo nomes transcritos errado cobre quando isso vale a pena.
Pontuações de confiança bem calibradas. A Nova-3 retorna confiança em nível de palavra que você pode usar downstream. Nosso post sobre pontuações de confiança em transcrição cobre como usá-las.
Limitações conhecidas
Onde a Nova-3 fica aquém, dito sem rodeios.
É fechada. Você não pode hospedar a Nova-3 localmente, rodá-la offline ou ajustá-la com seus próprios dados fora de um contrato empresarial. Para requisitos rígidos de residência de dados ou ambientes isolados, um modelo aberto como o Whisper é o único caminho. Nosso post sobre residência de dados para transcrição cobre quando essa restrição é um bloqueio definitivo.
Cobertura de idiomas fica atrás do Whisper. A Nova-3 suporta bem mais de 50 idiomas; o Whisper suporta cerca de 99 com qualidade variável. Para conteúdo em idiomas menos comuns, o Whisper geralmente vence por padrão. Nosso post sobre por que a IA sofre com idiomas de baixos recursos cobre essa lacuna.
Sem vantagem clara no áudio mais difícil. Em inglês limpo com um único falante, a Nova-3 e o Whisper Large-v3 chegam perto. Nas piores condições (sotaques carregados, áudio telefônico de baixa bitrate, falantes sobrepostos), a diferença entre eles é pequena e depende do caso de uso. Nosso explicador sobre o Whisper Large-v3 cobre essa comparação.
Sem trilha de auditoria pública. Como a arquitetura e os dados de treinamento não são públicos, avaliar viés sistemático ou modos de falha exige testes práticos, não leitura de um artigo. Para pesquisa ou uso regulado onde a procedência do modelo importa, essa opacidade é uma limitação real.
A diarização não tem limite documentado de falantes, em nenhuma direção. A diarização da Deepgram detecta falantes sem que você especifique uma quantidade antecipadamente, e a documentação não publica um máximo. Se você já viu alguma alegação de "suporta até 12 falantes" (inclusive numa versão anterior deste mesmo post), esse número não está na documentação da Deepgram. Trate a quantidade de falantes como algo a testar com seu próprio áudio de múltiplas partes. Nosso post sobre como lidar com múltiplos falantes em IA cobre o que a diarização consegue e não consegue fazer.
Preços em 2026
Aqui está o preço publicado de pay-as-you-go da Deepgram para o Nova-3. Os valores mudam, então confira na página de preços da Deepgram antes de montar um orçamento em cima deles.
| Modo | Preço (Nova-3, pay-as-you-go) |
|---|---|
| Pré-gravado (batch), monolíngue | Cerca de $0,0043 por minuto (~$0,26/hora) |
| Streaming, monolíngue | Cerca de $0,0077 por minuto (~$0,46/hora) |
Streaming multilíngue (multi) | Cerca de $0,0058 por minuto |
| Crédito grátis na inscrição | $200, sem expiração |
| Plano Growth | A partir de cerca de $4.000 por ano, com tarifas com desconto |
Nova-3 pay-as-you-go, 2026.
Duas coisas que o valor por minuto esconde. Primeiro, a Deepgram cobra por segundo, então cargas de trabalho com clipes curtos custam menos do que a tarifa por minuto sugere. Segundo, o crédito grátis de $200 cobre muitas centenas de horas de áudio em batch, então você pode avaliar o modelo antes de pagar qualquer coisa.
Como isso se compara a outras APIs
Está na moda chamar a Deepgram de “a mais barata”. Em transcrição em lote em 2026, isso não é mais verdade. Aqui estão as tarifas base pré-gravadas, normalizadas por hora, direto do preço de cada provedor.
| Provedor / modelo | Preço em lote (por hora) |
|---|---|
| AssemblyAI Universal-2 | $0.15 |
| Rev AI Reverb | $0.20 |
| AssemblyAI Universal-3.5 Pro | $0.21 |
| Deepgram Nova-3 | Cerca de $0.26 |
| OpenAI gpt-4o-transcribe | $0.36 |
| OpenAI gpt-4o-mini-transcribe | $0.18 |
A Nova-3 tem preço competitivo entre as APIs premium, mas não é a mais barata. O nível de IA da AssemblyAI e da Rev fica abaixo dela nas tarifas base em lote. Onde a Deepgram realmente ganha é na latência em tempo real e na cobrança por segundo, não no preço de tabela. Uma ressalva que faz qualquer tabela assim ser só um ponto de partida: essas são tarifas base de transcrição, e alguns provedores (a AssemblyAI deixa isso explícito) cobram separadamente por diarização de falantes, resumos e outros recursos de entendimento, então a tarifa base não é sua conta final.
Para criadores solo e times pequenos, nenhuma dessas APIs por minuto costuma ser a compra certa de qualquer forma. Quando você passa de cerca de 58 horas de áudio por mês, um plano ilimitado de valor fixo como o CATT Pro por US$ 14,99/mês supera o preço medido. Nosso comparativo de preços de transcrição mostra a matemática desse ponto de virada.
Streaming vs lote
A Nova-3 atende aos dois por endpoints diferentes, e os casos de uso são bem distintos.
Streaming
Streaming é para quando o usuário vê a saída enquanto ela é produzida: legendagem ao vivo, transcrição de reuniões em tempo real, entrada de assistente de voz, ferramentas de acessibilidade. Latência abaixo de 500 milissegundos importa, e a precisão absoluta pode cair um pouco porque o modelo costuma mostrar correções conforme ganha contexto. O streaming da Nova-3 retorna transcrições provisórias (melhor palpite, pode ser revisado) seguidas de transcrições finalizadas (bloqueadas) conforme chega mais áudio. A maioria das integrações lida com essa troca automaticamente.
Lote
Batch mode é para áudio pré-gravado. A latência é de segundos para arquivos curtos e minutos para os longos, e a precisão é maior que no streaming porque o modelo tem o contexto completo do áudio. A maior parte do trabalho padrão de transcrição, incluindo os uploads na ferramenta de transcrição de inglês da CATT, é em batch. O tempo real é comum em fluxos de legendagem ao vivo e mais raro em ferramentas de subir e esperar.
Como decidir entre Nova-3 e Whisper
Uma checklist rápida.
- Latência em tempo real importa: Nova-3.
- Requisito de hospedagem própria ou ambiente isolado (air-gapped): Whisper.
- Cobertura de 99 idiomas importa: Whisper.
- Cinquenta ou mais idiomas bem suportados bastam e você quer cobrança por segundo na nuvem: Nova-3.
- Conformidade com software fechado é aceitável e você quer infraestrutura gerenciada: Nova-3.
- Conformidade com código aberto é obrigatória: Whisper, sem discussão.
Para a maioria das ferramentas de transcrição em produção em 2026, a resposta honesta é "use os dois e faça o roteamento entre eles por requisição". É isso que o ConvertAudioToText e várias ferramentas no espaço de alternativas ao Otter fazem nos bastidores.
Perguntas Frequentes
Quanto custa o Deepgram Nova-3 por minuto?
A transcrição pré-gravada (em lote) do Nova-3 custa cerca de $0.0043 por minuto, aproximadamente $0.26 por hora, no plano pré-pago. A transcrição em streaming sai por volta de $0.0077 por minuto, cerca de $0.46 por hora. O streaming multilíngue fica em torno de $0.0058 por minuto. A Deepgram cobra por segundo de áudio, e contas novas ganham um crédito de $200 sem data de validade. Os preços mudam, então confirme na página de preços da Deepgram antes de fazer o orçamento.
O Nova-3 é mais preciso que o Whisper?
Nos benchmarks da própria Deepgram, o Nova-3 foi preferido em relação ao Whisper em todos os 7 idiomas testados, chegando a uma preferência de 8 para 1 em alguns casos. Esse é o teste da Deepgram, não um teste independente. Na prática, em áudio limpo com um único falante em inglês, os dois ficam próximos, e nos áudios mais difíceis (sotaques carregados, gravações de qualidade telefônica, fala sobreposta) a diferença é pequena e depende do seu áudio específico. O único número que importa é o que você mede por conta própria.
Quantos idiomas o Nova-3 suporta?
A Nova-3 foi lançada em janeiro de 2025 com 36 idiomas e, ao longo de 2025, expandiu para mais de 50, conforme a documentação atual da Deepgram. A alternância de código em tempo real, em que o modelo lida com áudio que mistura idiomas no meio da transmissão, é suportada em 10 idiomas: inglês, espanhol, francês, alemão, hindi, russo, português, japonês, italiano e holandês. O Whisper ainda cobre mais idiomas no total, cerca de 99, com qualidade variável.
Posso hospedar a Nova-3 por conta própria ou usá-la offline?
Não. A Nova-3 é um modelo comercial fechado. Você não pode baixá-la, executá-la offline ou ajustá-la com seus próprios dados fora de um contrato empresarial. Se precisar de auto-hospedagem, implantação em ambiente isolado ou controle total dos dados, um modelo aberto como o Whisper Large-v3 é o caminho a seguir.
O que é keyterm prompting e isso realmente ajuda?
O keyterm prompting permite que você envie até 100 termos esperados (nomes de empresas, nomes de produtos, jargão médico ou jurídico) junto com uma solicitação de transcrição, e a Nova-3 tende a priorizá-los sem precisar de retreinamento. Isso ajuda mais quando seu áudio está cheio de nomes próprios ou vocabulário de domínio que um modelo genérico deixaria passar. Para uma lista de nomes comuns, nomes de medicamentos ou termos técnicos, até uma lista curta de termos-chave melhora visivelmente a precisão nessas palavras específicas.
Quantos falantes a diarização da Nova-3 consegue lidar?
A diarização da Deepgram detecta falantes sem que você especifique um número com antecedência, e a documentação não publica um máximo. Alegações de um limite específico, como "até 12 falantes", não aparecem nos documentos da Deepgram. Trate o número de falantes como algo a verificar por conta própria no seu áudio multiparticipante, porque a qualidade da diarização em gravações sobrepostas ou lotadas varia conforme o motor.
A Deepgram Nova-3 suporta transcrição por streaming em tempo real?
Sim. O Nova-3 atende streaming por meio de um endpoint WebSocket com latência de ponta a ponta na faixa de 200 a 300 milissegundos em boas condições. Ele retorna transcrições provisórias que podem ser revisadas e, depois, transcrições finais que ficam travadas conforme mais áudio chega. Esse é o caso de uso mais forte do Nova-3 em comparação com modelos voltados a lote, como o Whisper.
O Nova-3 é a API de transcrição mais barata?
Não em lote. Em 2026, o AssemblyAI Universal-2 (US$ 0,15/hora), o Rev AI Reverb (US$ 0,20/hora) e o AssemblyAI Universal-3.5 Pro (US$ 0,21/hora) todos ficam abaixo da taxa base de lote do Nova-3, em torno de US$ 0,26/hora. O Nova-3 compete em latência em tempo real e cobrança por segundo, não no menor preço de tabela. Vale notar que alguns provedores cobram diarização e outros recursos separadamente, então as taxas base não representam o custo total.
Por onde começar
Se você só precisa de transcrições, o nível gratuito da CATT é uma opção sem configuração. Para avaliar o próprio Nova-3 com seu áudio, o crédito de US$ 200 por conta própria da Deepgram cobre centenas de horas de processamento em lote do Nova-3, o que é mais do que suficiente para comparar com seu fluxo atual antes de comprometer um orçamento.
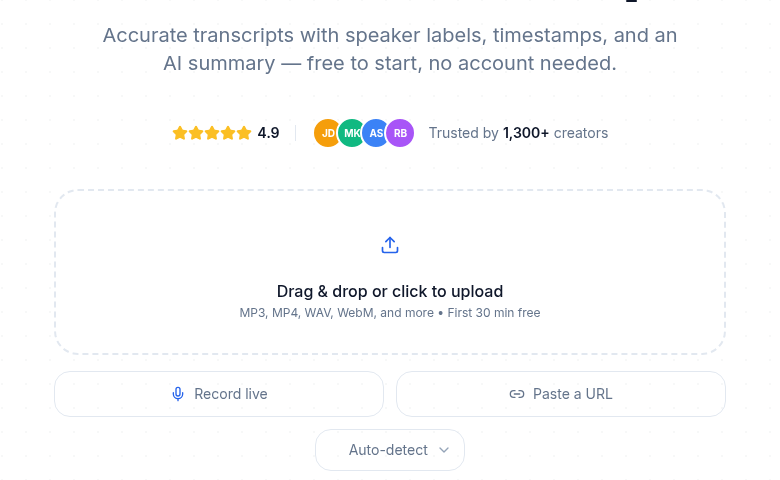 O uploader do ConvertAudioToText: solte um arquivo, grave ao vivo ou cole uma URL
Fontes
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Como funciona a transcrição com IA: o pipeline do produto explicado (2026)
Do upload à transcrição exportada: um passo a passo claro de cada etapa do pipeline de transcrição com IA, incluindo VAD, ASR, diarização, pós-processamento e exportação.
Modelos de Transcrição Open Source vs Proprietários em 2026
Comparação honesta entre o Whisper open source e APIs proprietárias como Deepgram e AssemblyAI. Custos verificados, faixas de precisão e quando cada um realmente faz sentido.