Como funciona a transcrição com IA: o pipeline do produto explicado (2026)
Summarize this article with:
Quando você envia um arquivo de áudio ou vídeo para uma ferramenta de transcrição com IA, o serviço executa seis etapas sequenciais antes de devolver sua transcrição: ingestão e pré-processamento, detecção de atividade de voz, codificação acústica e reconhecimento de fala, diarização, pós-processamento e formatação de exportação. Cada etapa tem seus próprios modos de falha e trade-offs de velocidade. Entendê-las ajuda você a escolher a ferramenta certa, diagnosticar resultados ruins e gravar áudios melhores desde o início.
Quando você envia um arquivo de áudio e a transcrição volta alguns minutos depois, seis etapas distintas do pipeline acontecem entre esses dois momentos. Este post percorre cada uma delas em ordem, desde o momento em que o arquivo chega ao servidor até a exportação formatada cair na sua pasta de downloads. Entender o pipeline mostra de onde vêm os erros, por que algumas ferramentas são mais rápidas e o que você pode fazer para melhorar os resultados sem trocar de serviço.
Este é o post sobre o pipeline do produto. Para a arquitetura neural técnica por trás da etapa de ASR, veja como funciona o reconhecimento de fala com IA. Para a evolução histórica dos sistemas baseados em regras até o aprendizado profundo, veja como funciona o reconhecimento de fala.
Etapa 1: Ingestão e Pré-processamento
A primeira coisa que um serviço de transcrição faz é converter seu arquivo em um formato interno padrão. A maioria dos pipelines reduz a amostragem para PCM mono de 16 kHz, porque é isso que os modelos de fala subjacentes esperam. Se o seu arquivo é um MP4 estéreo de 48 kHz de uma gravação do Zoom, o serviço remove a faixa de vídeo, mistura ou separa os canais de áudio e reamostra.
Arquivos de vídeo adicionam uma etapa extra: a faixa de áudio é extraída com uma ferramenta como o FFmpeg antes de o pipeline de áudio rodar. É por isso que um MP4 de 60 minutos demora um pouco mais que um MP3 de 60 minutos da mesma fonte.
É também nesta etapa que os erros de formato aparecem. Um cabeçalho M4A corrompido, um arquivo sem fluxo de áudio ou um arquivo criptografado enviado por engano como áudio são todos detectados aqui. Um serviço bem construído valida a entrada e retorna um erro claro antes de processar mais ou cobrar você por um trabalho que falhou.
Etapa 2: Detecção de Atividade de Voz
Antes de alimentar o modelo de fala com o áudio, o pipeline identifica quais trechos contêm fala de fato e quais contêm silêncio, ruído ou música. Esta etapa se chama detecção de atividade de voz (VAD).
O VAD é um porteiro: ele segmenta o áudio em regiões de fala e não fala. Uma abordagem simples baseada em energia mede a amplitude do áudio e marca regiões de baixa energia como silêncio. Os sistemas neurais modernos de VAD vão além, usando modelos de aprendizado de máquina treinados com ruídos do mundo real para distinguir fala de sons de fundo com níveis de energia semelhantes, como barulho de teclado ou zumbido de ar-condicionado.
Sem o VAD, um modelo de fala tentaria transcrever silêncio e ruído como palavras, produzindo texto alucinado nas pausas. Com ele, o modelo só recebe áudio que provavelmente contém fala, o que economiza computação, acelera o processamento e reduz inserções espúrias de palavras.
Para uma análise mais profunda de como os modelos de VAD funcionam no nível do sinal, o explicador sobre VAD cobre os detalhes técnicos.
Etapa 3: Codificação Acústica e Reconhecimento de Fala
Esta é a etapa que a maioria das pessoas quer dizer quando fala em "a IA". Ela tem duas partes.
Primeiro, o áudio é convertido em uma representação de características que o modelo consegue ler. Redes neurais não consomem amostras de áudio brutas. Elas consomem um espectrograma log-mel, que é um mapa bidimensional de como a energia é distribuída pelas bandas de frequência ao longo do tempo. Se você já viu um visualizador de música com barras horizontais empilhadas, está vendo algo parecido com o que o modelo enxerga. A escala mel comprime as faixas de alta frequência para corresponder à percepção auditiva humana, produzindo uma entrada compacta que retém a informação acústica que distingue um fonema de outro.
Segundo, uma rede neural mapeia essas características em tokens de texto. Três famílias de modelos dominam os pipelines de produção em 2026:
| Motor | Tipo | Principal diferencial |
|---|---|---|
| OpenAI Whisper Large-v3 | Código aberto | Forte cobertura multilíngue em 99 idiomas |
| Deepgram Nova-3 | SaaS fechado | Latência de lote abaixo de 300 ms, WER 54,2% menor que o concorrente mais próximo nos benchmarks da própria Deepgram |
| AssemblyAI Universal-3.5 Pro | SaaS fechado | Maior precisão em áudio pré-gravado, prompting de termos-chave em linguagem natural |
O Whisper Large-v3 em uma GPU moderna atinge um fator de tempo real (RTF) entre 0,072 e 0,15, o que significa que processa áudio de 7 a 14 vezes mais rápido que o tempo real, dependendo da GPU. O modo batch da Deepgram alcança um rendimento muito maior em escala. O Whisper apenas com CPU pode ser de 20 a 30 vezes mais lento, e é por isso que configurações auto-hospedadas em hardware fraco parecem tão diferentes das APIs em nuvem.
Minha opinião: para a maioria dos áudios corporativos, a escolha do motor importa menos do que a qualidade do áudio e a cobertura de vocabulário. Um arquivo de reunião bem gravado será transcrito com precisão em qualquer um desses três. Uma ligação ruidosa gravada pelo viva-voz vai sofrer em todos eles.
Para a comparação completa de precisão e preços entre estas e outras APIs, veja melhores APIs de fala para texto em 2026 e preços de APIs de fala para texto.
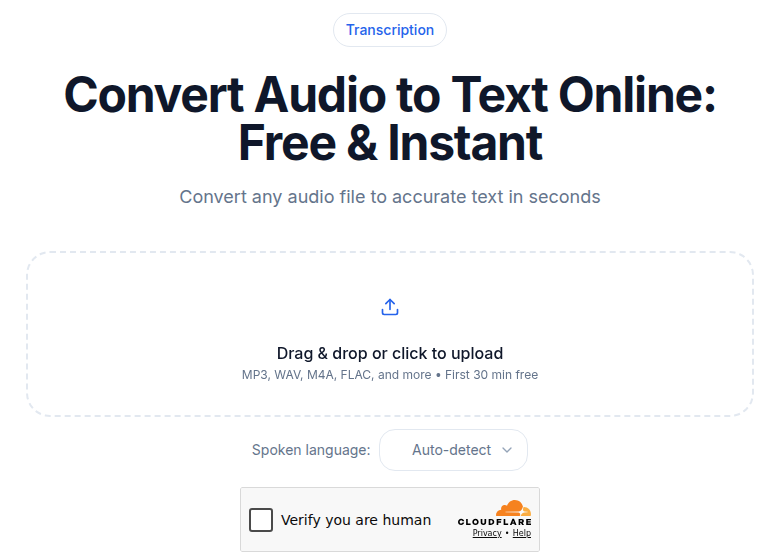 A ferramenta de upload de áudio do ConvertAudioToText, mostrando a interface de arrastar arquivo antes do início do processamento
Etapa 4: Diarização (Quem Disse o Quê)
Para gravações com um único falante, esta etapa é pulada ou trivial. Para entrevistas, reuniões e podcasts, a diarização é o que separa uma transcrição legível de um muro de texto indiferenciado.
A diarização roda um modelo separado em paralelo com o reconhecimento. Ela analisa características da voz (tom, timbre, cadência da fala) e agrupa segmentos de áudio por falante, depois atribui os rótulos "Falante 1:" e "Falante 2:" a cada fala.
Os casos difíceis estão bem documentados: fala sobreposta (duas pessoas falando ao mesmo tempo) e vozes parecidas (dois homens com o mesmo sotaque e faixa de tom). Benchmarks de pesquisa que medem a taxa de erro de diarização (DER) nos principais sistemas ficam consistentemente na faixa de 10 a 20 por cento em áudio conversacional de reuniões, sendo os conjuntos de dados com 15 a 19 por cento de fala sobreposta a condição mais difícil. Em áudio limpo de dois falantes gravado perto de cada microfone, o desempenho no mundo real é substancialmente melhor.
Para uma explicação técnica completa de como funciona o agrupamento da diarização, veja diarização de falantes explicada.
Etapa 5: Pós-processamento
A saída bruta de um modelo de fala é um fluxo de tokens em minúsculas, geralmente sem pontuação. "a reunião é às quatro da tarde devemos levar o notebook" é uma transcrição tecnicamente correta, mas não serve como documento.
O pós-processamento transforma tokens brutos em texto legível por meio de várias camadas:
- Normalização inversa de texto (ITN): converte "quatro da tarde" em "16h" e "dois mil vinte e seis" em "2026". Sistemas modernos de ITN usam transdutores de estados finitos ou modelos neurais treinados com pares de formas falada e escrita.
- Restauração de pontuação: insere vírgulas, pontos finais e pontos de interrogação com base em pausas, entonação e previsões de modelos de linguagem.
- Maiusculização: trata inícios de frase, nomes próprios e siglas.
- Remoção de preenchimentos (opcional): elimina "éh", "ahn" e falsos começos para a saída em modo limpo.
É aqui que a distinção entre modo literal e modo limpo é aplicada. Se você precisa da forma falada exata para uso em pesquisa, jurídico ou médico, escolha o modo literal. O modo limpo é melhor para legibilidade quando as disfluências exatas não importam. Veja precisão de transcrição explicada para saber mais sobre como cada camada afeta o texto final.
Etapa 6: Exportação e Formatação
A etapa final converte os dados estruturados da transcrição — texto mais marcações de tempo mais rótulos de falante — no formato que o seu fluxo de trabalho precisa.
Formatos de exportação comuns:
- TXT: texto simples, sem marcações de tempo. O mais rápido de visualizar e o mais fácil de colar em documentos.
- SRT: formato SubRip com blocos de legenda numerados e marcações de tempo. O padrão para YouTube, Facebook, LinkedIn, Premiere Pro e DaVinci Resolve.
- VTT: Web Video Text Tracks, um superconjunto do SRT usado nativamente por players de vídeo HTML5 e muitas plataformas online.
- DOCX ou PDF: documentos de editor de texto com rótulos de falante e códigos de tempo nas margens.
- JSON: dados estruturados com marcações de tempo no nível da palavra, pontuações de confiança e IDs de falantes, úteis para desenvolvedores que constroem aplicações a partir desses dados.
O formato que você escolhe é determinado pelo que você fará com a transcrição em seguida, não pela precisão. Arquivos SRT e VTT são os formatos a solicitar se você está adicionando legendas a vídeos. JSON é o formato a solicitar se você está enviando a saída para outro sistema. TXT simples serve para tudo que será lido por humanos.
Se você precisa de uma transcrição limpa sem que um bot de reunião entre na sua chamada, a ferramenta de áudio do ConvertAudioToText recebe qualquer arquivo que você enviar e executa esse pipeline completo sem exigir integração com calendário.
O Que Determina a Velocidade
Três variáveis definem o tempo total de resposta:
- Rendimento do modelo. O Deepgram Nova-3 em modo batch alcança fatores de tempo real muito altos em escala, mantendo a latência abaixo de 300 ms no streaming. O Whisper Large-v3 em GPU roda a aproximadamente 0,1 a 0,15 RTF em lote. Configurações apenas com CPU estão em um patamar completamente diferente.
- Disponibilidade de GPU. As APIs SaaS escalam horizontalmente. O Whisper auto-hospedado fica limitado à fila da sua GPU.
- Paralelismo das etapas. Pipelines bem construídos executam a diarização em paralelo com o reconhecimento, e não sequencialmente. Pipelines mal projetados os executam em série e pagam a penalidade duas vezes.
Modos Comuns de Falha
A transcrição com IA é precisa na maioria dos áudios corporativos, mas falha de forma previsível em condições específicas:
- Nomes próprios e marcas. "Coolify" vira "Cool if I". A correção é uma lista de vocabulário personalizado fornecida no nível da API, ou uma passada de localizar e substituir depois.
- Homófonos. "Conserto" vs. "concerto". Os modelos usam o contexto para escolher, e o contexto às vezes engana.
- Alternância de código. Falantes que trocam de idioma no meio da frase confundem modelos treinados com dados de um único idioma.
- Fala sussurrada ou gritada. Ambas ficam fora da distribuição acústica com a qual o modelo foi treinado.
- Números em contextos ambíguos. "Suite 200" vs. "sweet two hundred". A normalização inversa de texto lida com os padrões comuns, mas perde combinações incomuns.
Uma revisão de cinco minutos, com o áudio tocando ao lado da transcrição, é suficiente para capturar os 1 a 3 por cento que um modelo normalmente erra em áudio corporativo limpo.
Perguntas Frequentes
Quanto tempo leva a transcrição com IA para um arquivo de uma hora?
Depende do motor e da infraestrutura. O Deepgram Nova-3 em modo batch pode processar áudio a centenas de vezes a velocidade real, então um arquivo de 60 minutos pode ficar pronto em menos de um minuto. O Whisper Large-v3 em uma GPU moderna roda com fator de tempo real entre 0,1 e 0,15, o que coloca um arquivo de 60 minutos na faixa de 6 a 9 minutos. Configurações apenas com CPU são bem mais lentas. Na maioria das ferramentas SaaS com infraestrutura de GPU adequada, um arquivo de uma hora fica pronto em 2 a 8 minutos, incluindo a diarização.
Qual é a diferença entre uma transcrição limpa e uma transcrição literal (verbatim)?
Uma transcrição literal inclui todas as palavras de preenchimento ("éh", "ahn", "tipo"), falsos começos e palavras repetidas exatamente como foram faladas. Uma transcrição limpa remove esses elementos e pode reformatar levemente falas corridas em frases legíveis. A etapa de pós-processamento da IA decide qual versão você recebe. A maioria das ferramentas oferece uma opção de alternância; para casos de uso jurídicos, médicos ou de pesquisa em que a linguagem falada exata importa, escolha sempre a versão literal.
Por que a transcrição com IA erra nomes próprios e marcas?
Os modelos de fala são treinados em grandes corpora gerais e nunca encontraram o nome específico da sua marca, o nome do seu colega ou o termo do seu produto. Para um modelo sem contexto prévio, a sequência acústica de "Coolify" soa como "Cool if I". As soluções incluem listas de vocabulário personalizado (suportadas pelo Deepgram Nova e pelo AssemblyAI Universal-3), que você fornece no nível da API, ou uma passada manual de localizar e substituir depois que a transcrição chega.
Quão precisa é a diarização de falantes?
Em áudio limpo, de microfone único, com duas vozes claramente distintas, os modelos modernos de diarização identificam corretamente os falantes na maior parte do tempo. Em áudio real de reuniões, com fala sobreposta, vozes parecidas ou qualidade de telefone, as taxas de erro de diarização (DER) medidas nos principais sistemas acadêmicos e comerciais ficam consistentemente na faixa de 10 a 20 por cento. Os principais modos de falha são a fala sobreposta e vozes com tom e sotaque semelhantes.
Posso melhorar a precisão da transcrição com IA sem trocar de ferramenta?
Sim. A maior alavanca é a qualidade do áudio: um microfone USB a 15 cm do falante supera qualquer microfone de laptop em uma sala de conferência. Além do hardware, posicionar o microfone mais perto, usar uma sala silenciosa e gravar trilhas individuais para cada participante de uma reunião reduzem o piso de ruído contra o qual o modelo precisa trabalhar. No nível da API, fornecer uma lista de vocabulário personalizado para termos específicos do domínio (médico, jurídico, técnico) reduz mensuravelmente os erros em nomes próprios.
Fontes
- Benchmarks e latência do Deepgram Nova-3
- Entendendo a latência em APIs de fala para texto
- Página do produto AssemblyAI Universal-3.5 Pro
- Lançamentos da AssemblyAI de outubro de 2025: streaming multilíngue e melhorias na diarização
- Estado da diarização de falantes em 2026: benchmark pyannote vs Falcon
- AssemblyAI: aumentando a legibilidade da transcrição com pontuação, maiusculização e ITN
- Guia e configuração do Silero VAD
- Formatos de transcrição explicados: SRT, VTT, TXT, DOCX
- Benchmark do Whisper Large-v3: análise de velocidade e precisão
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Open Source vs Proprietary Transcription Models 2026
Honest tradeoffs between Whisper open-source and Deepgram, AssemblyAI, and other proprietary APIs. Verified costs, accuracy ranges, and when each actually makes sense.
Deepgram Nova-3 Pricing 2026: $0.0043/min Batch, $0.0077 Streaming
Deepgram Nova-3 costs $0.0043/min for batch and $0.0077/min for streaming in 2026. Honest accuracy vs Whisper, 50+ language coverage, keyterm prompting, and when Nova-3 beats cheaper alternatives like AssemblyAI.