
Baixa Confiança na Transcrição: O Que Significa e Como Corrigir
Summarize this article with:
"Baixa confiança" em uma transcrição significa que o sistema de reconhecimento de fala ficou em dúvida sobre aquelas palavras. Cada palavra recebe uma pontuação, geralmente entre 0 e 1, indicando a probabilidade de acerto segundo o sistema, e palavras abaixo de um limite são sinalizadas. Esse alerta serve para checar os trechos no áudio, não como prova definitiva de erro. Ruído, vozes sobrepostas, sotaques, nomes raros e números costumam ser as causas mais frequentes.
O que significa "baixa confiança na transcrição", em termos simples
| O que você vê | O que significa | O que fazer |
|---|---|---|
| Algumas palavras com baixa confiança | Nomes, números ou termos raros em que o sistema precisou adivinhar | Ouça essas palavras e faça o ajuste |
| Trechos inteiros com baixa confiança | O áudio estava difícil: ruído, distância, falas sobrepostas | Confira o trecho e melhore a gravação se puder |
| Baixa confiança no arquivo todo | Idioma incorreto, áudio muito ruim ou excesso de sobreposição | Defina o idioma falado manualmente e processe de novo |
| Alta confiança em tudo | O sistema teve certeza, o que indica áudio limpo | Ainda assim, confira nomes, números e homófonos |
Como corrigir uma transcrição com baixa confiança
- Revise primeiro as palavras sinalizadas. Ouça o áudio em cada ponto de baixa confiança e ajuste o texto. Isso resolve a maioria dos erros reais em uma fração do tempo de uma leitura completa.
- Confira o idioma selecionado. A detecção automática pode errar em áudios curtos ou multilíngues. Defina o idioma manualmente e processe o arquivo novamente.
- Melhore a gravação, não apenas o texto. Se seções inteiras apresentarem baixa confiança, reduza o ruído de fundo, aproxime o microfone e evite que várias pessoas falem ao mesmo tempo. Veja como melhorar a qualidade do áudio antes da transcrição.
- Identifique nomes e termos específicos. Nomes raros e termos técnicos são os que mais recebem baixa confiança. Ajuste uma vez e faça uma busca no texto pelo mesmo erro em outras partes.
Para ver todas as causas, leia por que ocorrem erros de transcrição e como melhorar a precisão da transcrição.
O que a pontuação realmente representa
A pontuação de confiança é a estimativa do motor, expressa em um número entre 0 e 1, de que uma palavra específica no texto está correta. Uma nota de 0,95 significa que o modelo estima cerca de 95% de chance de acerto. Uma nota de 0,42 indica incerteza bem maior.
Esse valor opera no nível da palavra na maioria das APIs comerciais. A Deepgram, por exemplo, retorna o campo confidence para cada palavra na resposta da API, definido em sua documentação como "um ponto flutuante entre 0 e 1 que representa a probabilidade estimada pelo modelo de que a palavra foi transcrita corretamente". Na prática, em áudio de boa qualidade, os valores se concentram perto de 1,0, pois em falas limpas o modelo realmente tem certeza da maior parte dos termos. O sinal útil está nos desvios.
A saída padrão do Whisper funciona de outro modo. Ele não expõe a confiança por palavra de forma nativa. Em vez disso, cada segmento traz avg_logprob (log-probabilidade média no segmento, onde valores mais negativos indicam menos certeza) e no_speech_prob (a estimativa do modelo de que não havia fala naquele trecho). Não há equivalente direto à pontuação por palavra da Deepgram sem pós-processamento adicional de probabilidades dos tokens. Ferramentas que integram o Whisper podem calcular estimativas por palavra por meio de alinhamento, mas isso não equivale a uma saída nativa individual.
Por que esses números são mais complexos do que parecem
Alta confiança não é garantia de acerto
Uma confiança de 0,99 significa que cerca de uma a cada cem palavras nessa faixa estará incorreta. Em uma transcrição de uma hora com 8.000 palavras, 1% de erro mesmo em "altíssima confiança" gera por volta de 80 falhas. O risco maior é que modelos neurais modernos podem ser sistematicamente confiantes demais, sobretudo com ruído. Pesquisas de 2024 e 2025 mostraram que alguns modelos de ASR preveem incorretamente de 10% a 20% dos tokens com confiança acima de 0,70 sob baixas relações sinal-ruído. Não se trata de falha de um serviço específico; reflete o comportamento das probabilidades softmax em decodificadores neurais sem calibração ajustada.
Palavras com alta confiança devem ser as últimas a revisar, mas ainda podem conter falhas.
Baixa confiança não significa erro garantido
Uma palavra com confiança de 0,45 pode estar perfeitamente correta. Geralmente, a baixa confiança apenas indica que o modelo avaliou opções plausíveis e escolheu uma por pequena margem. Nomes próprios pouco comuns no treinamento, números cujo contexto aceita vários valores e homófonos que só se esclarecem na frase seguinte lideram essas ocorrências. Confira essas palavras no áudio antes de presumir que estão erradas.
As pontuações não são comparáveis entre motores
Um valor de 0,85 da Deepgram e 0,85 de outro motor não afirmam a mesma coisa. A documentação da Deepgram esclarece com franqueza: "As definições e a calibração de pontuação de confiança variam entre provedores de STT. Você não pode comparar diretamente distribuições de confiança bruta entre provedores". Cada motor adota escalas de probabilidade próprias, ajustes de calibração distintos e até conceitos diferentes do que a nota representa. Comparar ferramentas pela média dessas pontuações significa confrontar dados incompatíveis.
Uma comparação real exige rodar o mesmo áudio em ambos, verificar o resultado manualmente e medir a taxa real de erros de palavras (WER). Veja entenda a precisão da transcrição para fazer essa medição da forma correta.
Nível de palavra vs. nível de segmento
A confiança por palavra atribui um valor a cada termo individual. Esse formato oferece a melhor usabilidade para revisão, permitindo pular direto para a palavra duvidosa.
A confiança por segmento atribui um único valor a um bloco de frase ou oração. A pontuação geral do segmento na Deepgram corresponde à mediana dos valores das palavras daquele trecho. O avg_logprob do Whisper é uma log-probabilidade de nível de segmento. Ambas servem para varrer textos longos e achar trechos problemáticos, mas nenhuma indica qual palavra específica gerou o alerta.
Para revisão prática de texto, o nível de palavra é muito superior. Para decisões de triagem (encaminhar este trecho para revisão humana), o nível de segmento costuma bastar.
Calibração: o que é e por que faz diferença
Uma pontuação de confiança bem calibrada reflete a precisão real dos dados. Se você reunir todas as palavras pontuadas em 0,90 pelo motor e checar uma a uma, exatamente 90% delas deveriam estar corretas. Isso é calibração. A Deepgram define sua confiança por palavra como uma "probabilidade calibrada", tendo essa meta como foco.
A maioria dos modelos neurais não sai perfeitamente calibrada de fábrica. Eles tendem ao excesso de confiança no topo: apontam 0,95 quando a precisão real ronda os 0,88. Técnicas como escalonamento de temperatura pós-processamento ajudam a corrigir isso, mas poucas plataformas divulgam se e como aplicam esses métodos.
Não assuma o índice de confiança como uma probabilidade matemática exata. Use-o como parâmetro relativo. Faça testes com seus próprios arquivos revisando amostras em faixas diferentes para ver a porcentagem real de acertos. A curva resultante revelará o peso real da pontuação no seu perfil de áudio. Uma entrevista com sotaque forte resultará em uma curva de calibração bem diferente de um podcast gravado em estúdio, mesmo usando o mesmo motor.
Como usar as pontuações de confiança na prática
Priorize a revisão da menor para a maior confiança
Em transcrições extensas, ordene ou filtre as palavras pela pontuação e revise primeiro as menores notas. A maior parte dos erros reais em um áudio de 90 minutos fica concentrada em poucas centenas de palavras abaixo de 0,70. Revisar esses pontos específicos no áudio resolve grande parte das falhas gastando muito menos tempo do que reler tudo do início ao fim.
A maioria das ferramentas de transcrição para usuários finais exibe isso com destaque de cores: termos com baixa confiança surgem em tom diferente para facilitar o clique. Ao trabalhar direto com a API bruta, filtre a lista pelo campo confidence e use os marcadores de tempo para checar o áudio.
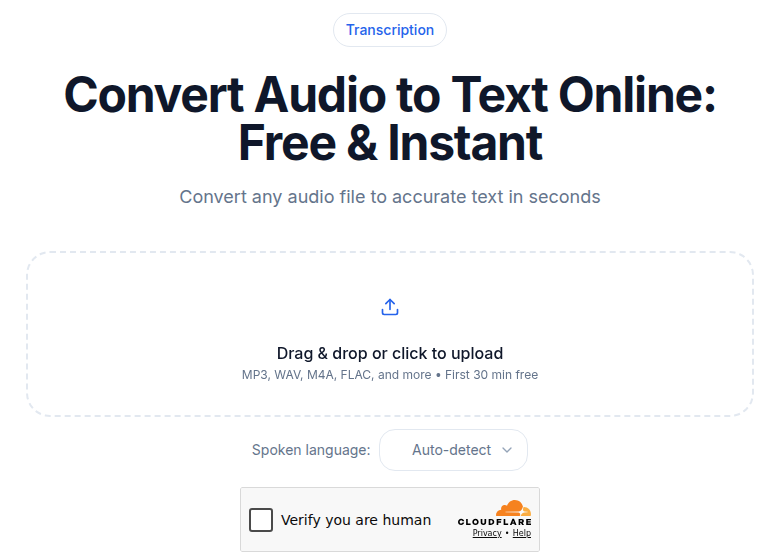 Ferramenta de upload de áudio no ConvertAudioToText onde a transcrição e a revisão começam
Defina um limite para controle de qualidade automático
Em fluxos com muito volume ou exigências de conformidade, defina um valor de corte para encaminhar termos ou transcrições inteiras abaixo dele à checagem humana. Um ponto de partida comum é 0,80 ou 0,85, embora o valor ideal dependa dos testes de calibração no seu próprio áudio.
A incerteza do modelo funciona como um filtro de qualidade nativo. Isso atende bem a fluxos em que o texto precisa atingir um padrão mínimo antes de seguir para outras etapas. Para saber mais sobre como baratear a produção de transcrições com qualidade, confira nossos artigos de custo que abordam o valor real de embutir revisões guiadas por confiança.
Pondere ocorrências de baixa confiança em outros sistemas
Se você desenvolve buscas ou painéis de dados a partir dos textos, trate o resultado como um sinal variável em vez de verdade absoluta. Um termo localizado com pontuação de 0,45 deve ter peso menor do que um com 0,98. Um relatório analítico que conta ocorrências de palavras precisa considerar essa ponderação. Caso contrário, um nome próprio mal interpretado distorcerá métricas e relatórios derivados.
O que o índice de confiança não detecta
Compreender as limitações do índice é tão importante quanto entender suas funções.
A confiança não identifica palavras incorretas que façam sentido no contexto. Termos parecidos na pronúncia, como 'sessão' e 'seção' ou 'mau' e 'mal', muitas vezes recebem alta confiança porque o motor optou por um antes de processar o restante da frase. São erros reais que passam batido pelas notas.
A confiança não acusa alucinações durante pausas silenciosas. Se o modelo inventar frases em um momento sem fala, a pontuação nesses termos pode até parecer razoável, embora o conteúdo seja falso. Trata-se de outro tipo de falha com indicadores próprios, sem ligação direta com o campo de confiança por palavra.
A confiança não valida a identificação dos locutores. O índice se refere apenas ao texto falado. A Deepgram traz o campo speaker_confidence em áudios pré-gravados para diarização, mas esse dado vem de um modelo diferente. São duas métricas separadas. Uma palavra pode estar correta no texto e atribuída à pessoa errada sem alterar a nota do vocábulo. Veja como funciona a diarização de locutores para entender melhor esse ponto.
A confiança não aponta palavras omitidas. Se o modelo simplesmente pulou um termo, não há nota para sinalizá-lo. Palavras que sumiram são as mais difíceis de notar após o processamento e fogem do escopo dessas pontuações.
Confiança entre motores: Deepgram e Whisper lado a lado
| Indicador | Deepgram | Whisper (referência) |
|---|---|---|
| Confiança por palavra | Sim, campo confidence (0-1) | Não fornecido nativamente na API |
| Sinal por segmento | Confiança do texto = mediana dos valores das palavras | avg_logprob (float negativo, quanto menor, menos certeza) |
| Detecção de silêncio | no_speech_prob fora da saída padrão | no_speech_prob por segmento |
| Confiança do locutor | speaker_confidence (apenas em pré-gravado) | Indisponível |
| Integração com limites de corte | Pronta para uso, sem pós-processamento | Exige ferramentas extras de alinhamento por palavra |
Para quem precisa de fluxos de revisão orientados por confiança ou filtros automatizados, o formato da Deepgram é mais direto. O avg_logprob do Whisper atende bem à triagem de blocos inteiros, mas requer processos extras para separar o valor de cada vocábulo. Veja entenda o Deepgram Nova-3 para mais detalhes do funcionamento desse motor.
Nossa recomendação: faça uma checagem de calibração em amostras do seu próprio material antes de estruturar fluxos automáticos com regras de corte. O que 0,80 representa nos seus arquivos pode ser bem diferente do resultado de terceiros, e a curva oscila conforme a qualidade do som.
Perguntas Frequentes
O que significa baixa confiança na transcrição?
Significa que o sistema de reconhecimento de fala ficou em dúvida sobre aquelas palavras. Cada palavra recebe uma nota, geralmente entre 0 e 1, indicando a probabilidade de estar correta. A baixa confiança marca trechos mais propensos a erros, muitas vezes causados por ruído, sobreposição de vozes, sotaque, nomes raros ou números. É um aviso para checar o áudio, não uma prova de erro.
Como corrijo uma transcrição com baixa confiança?
Reproduza o áudio nos pontos sinalizados e corrija as palavras manualmente. Se trechos inteiros tiverem baixa confiança, o problema costuma ser a gravação: reduza o ruído de fundo, aproxime o microfone, evite vozes simultâneas ou defina o idioma falado manualmente em vez de usar a detecção automática, e transcreva de novo.
A qualidade do áudio afeta a precisão da transcrição?
Sim, mais do que qualquer outro fator. Ruído de fundo, eco, distância do microfone, áudio de telefone com baixa taxa de bits e pessoas falando ao mesmo tempo reduzem a precisão e diminuem as pontuações de confiança.
O que é uma boa pontuação de confiança na transcrição?
Não existe um limite universal porque as escalas variam entre os motores. Em um mesmo motor, palavras abaixo de 0,80 merecem atenção. Abaixo de 0,60, quase sempre precisam de revisão. Mas esses valores servem como referência, não garantia: uma palavra com 0,99 pode estar errada, e uma com 0,55 pode estar certa.
As pontuações de confiança são comparáveis entre Deepgram, Whisper e outros motores?
Não. A documentação da Deepgram afirma explicitamente que a definição e a calibração de confiança variam entre provedores e que valores brutos não podem ser comparados diretamente. Uma pontuação de 0,85 na Deepgram e 0,85 em outro motor não representam o mesmo nível de precisão.
Por que uma palavra de alta confiança às vezes está errada?
O modelo define as palavras token por token, antes de ter todo o contexto disponível. Palavras com som parecido ('sessão' e 'seção', 'mau' e 'mal') podem obter alta confiança porque o modelo não as considerou ambíguas na hora, mesmo escolhendo a errada. O excesso de confiança com ruído também é amplamente documentado em pesquisas de ASR.
Uma pontuação de baixa confiança significa que a palavra está errada?
Não necessariamente. A baixa confiança indica que o modelo encontrou vários candidatos plausíveis e escolheu um por uma margem pequena. Esse termo escolhido pode estar correto. Os casos mais comuns de baixa confiança são nomes próprios, números e homófonos em que o contexto imediato não foi suficiente para definir um vencedor claro.
Para conferir seus próprios arquivos, a ferramenta de áudio para texto do ConvertAudioToText transcreve os primeiros 30 minutos sem exigir cadastro, com marcações de tempo para você checar trechos com facilidade no áudio.
Fontes
- Documentação de Confiança da Deepgram: definição, calibração e limitações entre provedores, consultado em 14-10-2026
- Documentação de Diarização da Deepgram - campo
speaker_confidenceem saídas pré-gravadas, consultado em 02-07-2026 - Campos verbose_json do OpenAI Whisper - confirmação de
avg_logprobeno_speech_probpor segmento, sem confiança nativa por palavra, consultado em 02-07-2026 - Avaliação de Confiança em ASR, arXiv 2503.15124 - detecção automatizada de erros via confiança, 2025
- Artigo do ICLR 2024 sobre calibração de confiança em ASR - comportamento de excesso de confiança em modelos neurais
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Por que a IA tem dificuldade com idiomas de baixos recursos: uma análise honesta em 2026
Escassez de dados de treinamento, complexidade tonal e falta de benchmarks explicam a lacuna de precisão na transcrição de idiomas de baixos recursos.
Transcrevendo Áudio de Baixa Qualidade: O Que Pode Ser Salvo (2026)
Orientação realista para transcrever áudio degradado: fitas cassete, chamadas em viva-voz, microfones distantes.
Precisão de Transcrição Explicada: O Que 99% Realmente Significa
O que 95% de precisão de transcrição realmente significa: a matemática do WER, truques de benchmark e o tempo de edição por trás de cada faixa de precisão.
Melhore a qualidade do áudio antes da transcrição: o que realmente ajuda
A cadeia de processamento pré-upload que ajuda (mono, normalizar, remover ruído) e as etapas que desperdiçam seu tempo, com toda honestidade.