対応音声フォーマット:互換性一覧表
Summarize this article with:
互換性テーブル
主要な文字起こしツールは、MP3、WAV、M4A、MP4をすべて受け付けます。違いが出るのは、あまり一般的でないフォーマット、ファイルサイズの上限、コーデックの制限です。アップロードする前に以下の表でフォーマットを確認し、その後のセクションで実際に失敗を引き起こすエッジケースについての文脈を読んでください。
| フォーマット | タイプ | CATT | Otter.ai | TurboScribe | Descript | Rev.com | Trint | Fireflies | Happy Scribe | AWS Transcribe | OpenAI Whisper API |
|---|---|---|---|---|---|---|---|---|---|---|---|
| MP3 | 音声 | はい | はい | はい | はい | はい | はい | はい | はい | はい | はい |
| WAV | 音声 | はい | はい | はい | はい | はい | はい | はい | はい | はい | はい |
| M4A | 音声 | はい | はい | はい | はい | はい | はい | はい | はい | いいえ* | はい |
| FLAC | 音声 | はい | いいえ | はい | はい | はい | いいえ | いいえ | はい | はい | いいえ |
| AAC | 音声 | はい | いいえ | はい | はい | はい | はい | いいえ | はい | いいえ | いいえ |
| OGG | 音声 | はい | はい | はい | いいえ | いいえ | いいえ | いいえ | はい | はい | いいえ |
| Opus | 音声 | はい | いいえ | はい | いいえ | いいえ | いいえ | いいえ | はい | はい (OGG/WebM経由) | いいえ |
| WMA | 音声 | はい | はい | はい | いいえ | いいえ | はい | いいえ | はい | いいえ | いいえ |
| AIFF | 音声 | いいえ | いいえ | はい | はい | いいえ | いいえ | いいえ | はい | いいえ | いいえ |
| MP4 | 動画 | はい | はい | はい | はい | はい | はい | はい | はい | はい | はい |
| MOV | 動画 | はい | はい | はい | はい | はい | はい | いいえ | はい | いいえ | いいえ |
| AVI | 動画 | はい | はい | はい | いいえ | いいえ | はい | いいえ | はい | いいえ | いいえ |
| MKV | 動画 | はい | はい | はい | いいえ | いいえ | いいえ | いいえ | はい | いいえ | いいえ |
| WebM | 動画 | はい | いいえ | はい | いいえ | いいえ | いいえ | はい | はい | はい | はい |
*AWS Transcribeのバッチ処理はMP4コンテナ(AAC音声を内包可能)をサポートしますが、ドキュメント上はスタンドアロンのM4Aファイルを名前指定ではサポートしていません。ご自身のユースケースで確認してください。
確認日: 2026年7月。出典はページ下部に記載。
ファイルサイズと時間の上限
ここで多くの人が驚きます。 フォーマット対応の有無よりも、ファイルがサービスのアップロード制限に物理的に収まるかどうかの方が重要です。
| サービス | ファイルサイズ制限 | 時間制限 | 備考 |
|---|---|---|---|
| ConvertAudioToText | 100 MB | 上限なし | プランごとに分単位の割り当てあり |
| Otter.ai | 5 GB | 明示なし | 無料は生涯3件のインポート、Proは月10件 |
| TurboScribe | 5 GB | 10時間 | Unlimitedプランは最大50ファイル同時処理 |
| Descript | プロジェクトあたり50 GB | 自動文字起こしは15時間 | 3チャンネル以上はステレオにダウンミックス |
| Rev.com | 2 GB(APIアップロード)、5 TB(URL) | 17時間 | 法務用文字起こしは合計20 GB |
| Trint | 3 GB(推奨) | 3時間(推奨) | より大きなファイルも受け付けるがエラーが出やすい |
| Fireflies | 200 MB | 150分 | 無料枠は100 MBまで |
| Happy Scribe | 明示なし | 明示なし | オーディオ31形式、ビデオ16形式に対応 |
| AWS Transcribe | 2 GB | 4時間 | バッチ処理ではファイルをS3に置く必要あり |
| OpenAI Whisper API | 25 MB | 明示なし | WAVに最も影響大、25 MBのWAVは約25分の音声に相当 |
| Deepgram(API) | 2 GB | 明示なし | 100以上のフォーマット、ビデオからの音声抽出も可能 |
| AssemblyAI(API) | 2.2 GB(アップロード)、5 GB(URL) | 10時間 | ネイティブフォーマットでの提出を推奨 |
OpenAI Whisper APIの25 MB制限は、最も混乱を招きやすいポイントです。2時間のインタビューをWAVファイルで保存すると、通常1 GB以上になります。制限は時間ではなくファイルサイズにかかっているので、96 kbpsの2時間MP3(約86 MB)でもアップロードに失敗します。回避策は、ビットレートを下げて圧縮するか、ファイルサイズに合わせて設計されたサービスを使うことです。
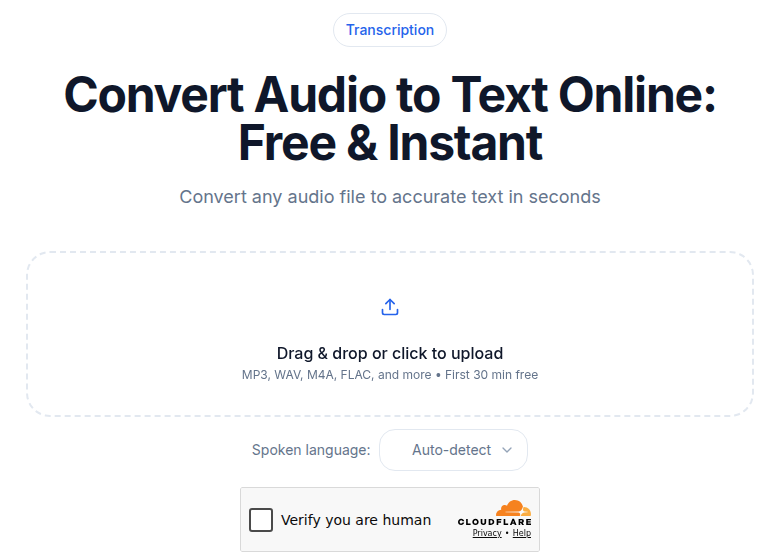 ConvertAudioToTextの音声アップロードツール
ConvertAudioToTextのアップローダーは、MP3、WAV、M4A、FLAC、AAC、OGG、Opus、WMA、および主要なビデオコンテナ形式に対応しています。100 MBのファイルごとの制限はアップロードに適用され、URL経由のジョブ(YouTube、Vimeo、直接リンク)はこの制限の対象外です。
音声フォーマット、それぞれの実態
MP3
MP3は安全なデフォルトです。 ほぼすべてのツールで受け入れられ、ファイルサイズも小さく、128 kbps以上ならWAVと比べて精度の面で実質的な差はありません。64 kbpsを下回ると、圧縮によるアーティファクトが音声の明瞭さを損ない始めます。32 kbpsの古い留守番電話の録音が、最もよくある問題の原因です。
実際のファイルサイズの目安は、128 kbpsで1分あたり約1 MB。2時間の録音なら約115 MBで、Whisper APIの上限は超えますが、他のサービスなら問題なく収まります。
WAV
WAVはロスレスですが、重要なのはアーカイブ用であって、文字起こしの精度のためではありません。 同じ音声録音をWAVと128 kbpsのMP3で比較した場合、最新のAIモデルによる文字起こし結果はほぼ同一です。実際の違いはファイルサイズで、WAVはCD品質(44.1 kHz、16ビットステレオ)で1分あたり約10 MBになります。
ファイルサイズの制限に引っかかる場合は、アップロード前にMP3へ変換してください。精度は一切失われません。
M4A
iPhoneのボイスメモはM4Aで書き出されます。 MP4コンテナ内でAAC圧縮を使用しており、MP3より効率的です。同等品質のMP3よりファイルサイズがわずかに小さく、主要な消費者向け文字起こしツールはすべて対応しています。
AWS Transcribeのバッチドキュメントでは、M4Aはサポート対象のフォーマットとして明記されていません。AWS APIを直接使う場合は、先にMP3かWAVへ変換してください。消費者向けツール(CATT、TurboScribe、Otter、Descript、Rev)はネイティブで処理できます。
FLAC
FLACはロスレス圧縮です。 ファイルサイズはWAVより50〜70パーセント小さく、元の音声のすべてのビットを保持します。文字起こしの目的では、適切にエンコードされたMP3と比べて精度の利点はありませんが、オリジナルをアーカイブしつつ単一ファイルをアップロードしたい場合に便利です。
ただし、すべてのサービスが対応しているわけではありません。Otter.ai、Fireflies、TrintはFLACを受け付けないので、アップロード前に確認してください。
OGG / Opus
**OGG Vorbis と Opus はオープンソース形式で、**Android の録音や Web アプリでよく使われます。特に Opus は WebRTC(ブラウザ録音、音声通話、Discord の書き出し)で利用されています。一般向けサービスでの対応はまちまちで、Descript、Rev、Fireflies は OGG を直接サポートしていません。AWS Transcribe と Deepgram はそれぞれのコンテナ経由で両方に対応しています。
ソースが OGG の Android 録音なら、互換性を最大限にするためにまず MP3 に変換しましょう。
WMA
**Windows Media Audio は実用からは姿を消しつつありますが、**古い Windows ボイスレコーダーの書き出しやレガシーなコールセンター録音には今も残っています。TurboScribe、Otter.ai、Trint は受け付けますが、Descript、Fireflies、Rev は対応していません。
AIFF
**AIFF は Apple の非圧縮形式で、**GarageBand や Pro Tools でよく生成されます。ファイルサイズは WAV と似ています。この表のサービスで AIFF を受け付けるのは TurboScribe と Descript だけです。DAW が AIFF で書き出す場合は、アップロード前に利用予定のサービスを確認してください。
動画形式と音声抽出
この表の全サービスは、動画から音声トラックを自動的に抽出します。アップロード前に動画を前処理する必要はありません。
MP4 はどこでも使えます。 MOV はほとんどの一般向けサービスで使えますが、AWS Transcribe と Fireflies では不可です。MKV は対応が限定的です(CATT、Otter、TurboScribe、Happy Scribe)。ソースが MKV や AVI で、対応していないサービスを使う場合は、FFmpeg で音声を MP3 に抽出してください: ffmpeg -i input.mkv -vn -ab 192k output.mp3。
動画ファイルからの字幕出力の詳細は、SRT vs VTT vs TTML: どの字幕形式を使うべきか をご覧ください。
形式が精度に影響する場合(そして影響しない場合)
ほぼすべての実用的なケースで、形式は精度に影響しません。 現代の AI 文字起こしモデルはデコード後の音声波形を処理するため、通常の品質設定ではコンテナ形式や圧縮コーデックに実質的な違いはありません。
形式が本当に重要になるケースは次の 3 つです:
非常に低いビットレートのMP3(64 kbps未満)。 64 kbps未満のオーディオにおける圧縮アーティファクトは、人間のリスナーとAIモデルの両方にとって音声の明瞭性を低下させる可能性があります。これは、非常に古いポッドキャストのアーカイブ、圧縮されたボイスメールの書き出し、そして極端に小さく圧縮されたストリーミングオーディオで見られます。
多世代の再エンコード。 WAVをMP3に、OGGに、そして再びMP3に変換すると、損失圧縮が積み重なり、各ステップで品質が失われます。可能な限り、元のソースファイルから作業してください。
破損または切り詰められたファイル。 部分的にダウンロードされたファイルや中断された録音は、フォーマット検証を通過しても、文字起こしの途中で失敗する可能性があります。ソースを再ダウンロードするか、再エクスポートしてください。
APIレベルでサンプルレートとチャンネル数が精度にどのように影響するかについて詳しくは、文字起こし精度の解説の投稿をご覧ください。
知っておく価値のあるコーデックの癖
静かに失敗を引き起こすいくつかの具体的な点:
AWS TranscribeのOGGはOpusコーデックを必要とします。 このサービスはOGGとWebMコンテナを受け入れますが、内部はOpusオーディオのみです。OGG Vorbisファイルは失敗します。これは入力要件に文書化されています。
Google Cloud STTはエンコーディングの宣言を必要とします。 Deepgramとは異なり、GoogleのAPIはリクエスト内でオーディオのエンコーディングを指定する必要があります。エンコーディングフィールドにMP3を宣言せずにMP3を送信すると失敗します。V2 APIは一部のフォーマットを自動検出できますが、V1はできません。
マルチチャンネルオーディオ(2チャンネル以上)。 AWS Transcribeは2チャンネルを超えるオーディオをサポートしていません。Descriptはインポート時に3チャンネル以上のファイルを自動的にステレオにダウンミックスします。マルチチャンネル(4チャンネルの会議レコーダー、アンビソニックマイク)で録音している場合は、APIベースのサービスにアップロードする前にステレオにダウンミックスしてください。
WAV内のPCMエンコーディング。 ほとんどのWAVファイルはPCMエンコーディングを使用しており、どこでも動作します。珍しいエンコーディング(GSM、ADPCM)を持つWAVファイルは、コンテナが認識されても一部のサービスで失敗する可能性があります。FFmpegのffprobeを使用すると、WAVファイル内のエンコーディングを確認できます。
録音からアーカイブまでのパイプライン全体におけるフォーマット選択の広い視点については、文字起こしファイルフォーマットの解説と文字起こしにおけるWAVとMP3の比較をご覧ください。
サポートされているフォーマットへの変換
サポートされていないフォーマットのファイルがある場合や、アップロード前にファイルサイズを縮小する必要がある場合は、音声からテキストへのツールがファイルを直接受け取り、内部で変換を処理します。プログラムによるワークフローでは、以下のワンライナーがほとんどのケースをカバーします:
ffmpeg -i input.anyformat -vn -ar 16000 -ac 1 -ab 64k output.mp3
これにより音声が抽出され、16 kHzのサンプルレート(音声認識に十分)が設定され、モノラルに変換され、64 kbpsでエンコードされます。これで1時間のWAVファイルが約600 MBから約30 MBに縮小され、文字起こしの精度は失われません。
元のファイルを保持しつつ、アップロード用の小さなコピーだけが必要な場合も、同じコマンドで対応できます。-ab 128kにすると余裕が生まれ、どのサービスの上限内でも十分に収まります。
ミーティングボットやビデオエディターを使わずに、クリーンな文字起こしだけが必要な場合は、ConvertAudioToTextがこの表の全フォーマット(AIFFを除く)を受け付け、ほとんどのファイルを1分以内に処理します。
よくある質問
文字起こしの精度に最適な音声フォーマットは何ですか?
ロスレスフォーマット(WAV、FLAC)や高品質のロッシーフォーマット(128 kbps以上のMP3、標準品質のM4A)は、どの最新AIモデルでも同じ文字起こし精度を生み出します。録音環境とマイクの品質が、音声フォーマットよりもはるかに重要です。アーカイブ用にはWAVまたはFLACを保存し、ファイルサイズを管理しやすくするためにMP3をアップロードしてください。
OpenAI Whisper APIが他のサービスでは受け付けるファイルを拒否するのはなぜですか?
Whisper API は25 MBのファイルサイズ上限を強制しており、これは他のサービスよりかなり低いです。128 kbpsの1時間MP3は約57 MBになるため、アップロードに失敗します。解決策としては、ビットレートを下げて圧縮する(音声には64 kbpsで十分)、ファイルを分割する、または25 MB制限のないサービスを使うことです。
動画ファイルを直接アップロードできますか、それとも先に音声を抽出する必要がありますか?
この表のすべてのサービスに動画を直接アップロードできます。音声トラックは自動的に抽出されます。MP4はどこでも使えますが、MOVやMKVはAWS TranscribeのようなAPIレベルのサービスでは対応がまちまちです。APIを直接使っていて、動画形式がサポートリストにない場合は、先にFFmpegで音声を抽出してください。
マルチチャンネル(サラウンド)録音は対応していますか?
ほとんどの文字起こしツールはステレオにダウンミックスするか、2チャンネル以上を明示的にサポートしていません。AWS Transcribeは2チャンネルのハードリミットを明記しています。Descriptはインポート時にダウンミックスします。確実な結果を得るには、アップロード前にマルチチャンネル録音をモノラルまたはステレオに変換してください。
出典
- Deepgram が対応する音声フォーマット: developers.deepgram.com/docs/supported-audio-formats (2026年7月確認)
- Amazon Transcribe の入力要件: docs.aws.amazon.com/transcribe/latest/dg/how-input.html (2026年7月確認)
- OpenAI Whisper API のドキュメント: help.openai.com/en/articles/7031512-audio-api-faq (2026年7月確認)
- Google Cloud Speech-to-Text のエンコーディング: docs.cloud.google.com/speech-to-text/docs/encoding (2026年7月確認)
- Otter.ai のインポートヘルプ: help.otter.ai (2026年7月確認)
- TurboScribe のサポート: turboscribe.ai/support (2026年7月確認)
- Descript が対応するファイルタイプ: help.descript.com (2026年7月確認)
- Rev.com が受け付けるファイル形式: support.rev.com (2026年7月確認)
- Trint が対応するファイル仕様: info.trint.com/knowledge/supported-file-specifications (2026年7月確認)
- Fireflies のアップロードガイド: guide.fireflies.ai (2026年7月確認)
- Happy Scribe のフォーマット: happyscribe.com/formats (2026年7月確認)
- AssemblyAI のファイル制限: assemblyai.com/docs/faq (2026年7月確認)
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Spotify Transcript Extractor: How to Copy and Download Episode Text
Get a Spotify podcast transcript you can copy and download: paste a public episode link, 30 minutes free with no signup, TXT or SRT files on eligible plans.
Call Transcription for Customer Support QA: A Practical CATT Workflow
Use call transcription for customer support QA to review calls faster and coach agents. Upload audio or a meeting URL, get speaker labels and AI summaries.