
2026年、アジア言語の文字起こしに最適なツール
Summarize this article with:
中国語と広東語なら、SenseVoice(Alibabaのオープンモデル)がWhisperよりCERで勝る。日本語と韓国語はWhisper Large-v3とNaver CLOVA Speechがリード。インドの言語ではAzure Speechが最も強い専門オプションだ。全アジア言語で勝つ単一エンジンはない。Whisperベースのツールは低コストで多言語の幅に優れ、言語特化ベンダーは対象言語の深さで勝負する。
どの単一の文字起こしエンジンも、アジア言語すべてでトップの性能を誇るわけではない。 正しい選択は、必要な言語、求める精度、そして製品を開発しているのか手動でファイルを処理しているのかによって変わる。この記事では、主要なアジア言語それぞれについて、検証可能なベンチマークのCER/WER数値をもとに、最も性能の高いエンジンをマッピングする。
なぜアジア言語の精度は別問題なのか
アジア言語の精度ベンチマークは、英語とは異なる指標を使う。中国語、日本語、韓国語の場合、CER(文字誤り率)が正しい尺度だ。なぜなら、これらの文字体系は単語間にスペースを使わないからだ。WER(単語誤り率)を使うには「単語」を定義する必要があるが、それはこれらの文字体系の仕組みにうまく対応しない。
この区別を頭に入れて、ベンダーの主張を比較してほしい。日本語で「精度95%」と報告するベンダーが、それがWERなのかCERなのかを明示していない場合、おそらくより緩い定義を使っている。この点については、文字起こし精度の解説の記事で詳しく扱っている。
北京語と広東語:SenseVoiceがリード
北京語では、SenseVoice(AlibabaのFunAudioLLMチームによるオープンモデル)が標準ベンチマークで10.78%のCERを達成し、Whisper Large-v3の12.55%を上回る。 広東語ではその差はさらに広がり、SenseVoiceは7.09%のCER、Whisper Large-v3は10.41%にとどまる。速度面では、SenseVoiceはApple Silicon上でリアルタイムの52〜118倍の速さで動作し、同等ハードウェア上のWhisperの13〜14倍を大きく凌ぐ。
SenseVoiceはオープンソースモデルであり、SaaS製品ではない。Alibabaの商用音声APIは、Alibaba Cloud Model Studio(Fun-ASR 1.5、2026年4月リリース)を通じて利用でき、中国のエコシステム内における本番の北京語ワークフローに適している。ドキュメントはalibabacloud.comで英語版が提供されている。
iFlytekは独立した企業で、医療、法律、金融といった専門的な中国語ドメイン向けに10年以上サービスを提供しており、ドメイン特化の語彙モデルを備えています。価格は非公開で、直接の問い合わせが必要です。中国国外の開発者にとっては、ドキュメントの使い勝手に実質的な障壁があります。
中国国外での中国語ワークフローには、OpenAI WhisperやGoogle Cloud STT Chirpの方がアクセスしやすく、精度も同等レベルです。
日本語と韓国語: Whisperは健在、韓国語の深みではCLOVAが勝る
Whisper Large-v3は日本語と韓国語の両方で8〜12%のCERを達成しており、この2言語ではSenseVoiceを上回ります(SenseVoiceの強みは特に中国語と広東語です)。日本語の場合、Whisperの弱点は方言のバリエーションが多い自発的な会話音声で、フォーマルな発話はきれいに書き起こせます。
韓国語では、Naver CLOVA SpeechがNAVER自身の研究データに支えられた専用オプションです。韓国語、英語、日本語、簡体字中国語に対応し、2024年には韓国語、英語、日本語のリアルタイムストリーミングが追加されました。韓国語特有の敬語や、フォーマルとインフォーマルの使い分けは、CLOVAの方がWhisperより優れています。アクセスはNAVER Cloud Platform経由で、英語のドキュメントも用意されています。
私の見解としては、日本語の書き起こしなら、OpenAI API経由のWhisper Large-v3か、Whisperベースのサービスが最も簡単な出発点です。韓国語では、Whisperは一般的な用途で十分ですが、専門的なドメイン語彙や韓国製プロダクトとの統合が必要なら、CLOVAを評価する価値があります。
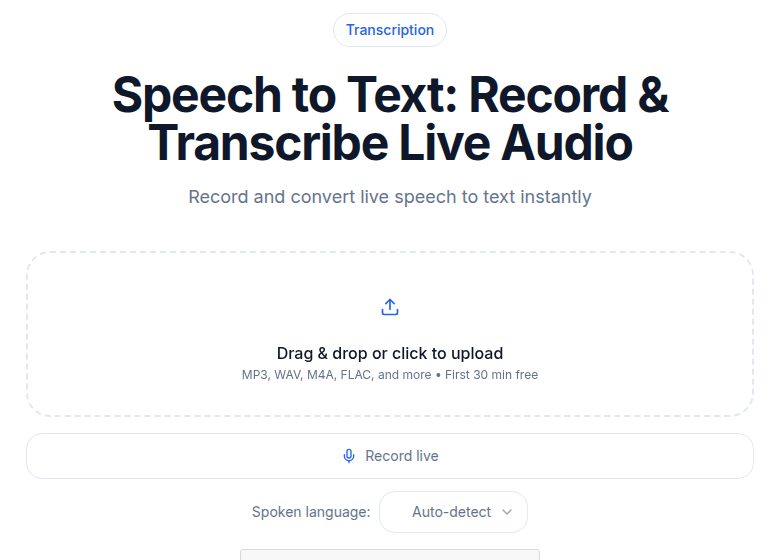 ConvertAudioToText音声認識ツールのインターフェース
インドの言語: Azure Speechが幅広くカバー
Microsoft Azure Speechは、インド言語のトレーニングデータに特に投資しており、ヒンディー語(hi-IN)、タミル語(ta-IN)、テルグ語(te-IN)、ベンガル語(bn-IN/bn-BD)、マラーティー語(mr-IN)、グジャラート語(gu-IN)、パンジャブ語、アッサム語、オリヤー語をサポートしています。話者数ベースでインド言語市場の90%以上をカバーします。Whisperはヒンディー語で9〜14%のWERを達成し、他の主要なインド言語も処理できますが、Azureはインド言語の音韻論とアクセントのばらつきに特化したトレーニングを行っているため、本番利用では優位性があります。
Azure SpeechのリアルタイムSTTは標準で1時間あたり$1.00、高速文字起こしで$0.36、バッチ処理で$0.18です(2026年半ば時点のベンダー資料による)。無料枠には月5時間の音声が含まれます。
Google Cloud STT Chirpもヒンディー語、タミル語、テルグ語、ベンガル語(ベンガル語はChirp 2のみ)をカバーしており、価格はリアルタイムで1分あたり$0.016、バッチで$0.004です。完全な比較はGoogle Cloud Speech-to-Textの価格内訳をご覧ください。
東南アジア言語: Google Cloud ChirpとWhisper
ベトナム語、タイ語、インドネシア語、タガログ語/フィリピン語、マレー語については、利用できるエンジンが少なくなります。Google Cloud STT Chirp(V2)はこれらすべてをカバーしており、タイ語(th-TH)、ベトナム語(vi-VN)、インドネシア語(id-ID)は完全にサポートされています。タガログ語とマレー語もV2で利用可能です。
Whisperの精度は、トレーニングデータが少ない声調言語で低下します。タイ語は18〜26%のWER、ベトナム語は15〜22%のWERとなっており、これは声調の複雑さと、北京語や日本語と比べたトレーニングデータ量の少なさが原因です。多くのワークフローでは実用的な数値ですが、英語には及びません。
AssemblyAIのUniversalモデル(ドキュメントで確認済み:日本語、韓国語、北京語、ヒンディー語、タイ語、ベトナム語、インドネシア語はすべて対応)は、Universal-2が$0.15/hr、Universal-3.5 Proが$0.21/hrで価格設定されています。利点は、話者分離、感情分析、トピック抽出を同じAPI呼び出しで取得できること。欠点は、東南アジア言語の言語別精度が公にベンチマークされていない点です。
言語別クイックリファレンス
| 言語 | 最適な汎用オプション | 最適な専門オプション | Whisper Large-v3精度 |
|---|---|---|---|
| 北京語 | Google Cloud STT Chirp、OpenAI Whisper | Alibaba Cloud Model Studio(Fun-ASR) | 12.55% CER |
| 広東語 | OpenAI Whisper | SenseVoice(セルフホスト) | 10.41% CER |
| 日本語 | OpenAI Whisper | OpenAI Whisper | 8-12% CER |
| 韓国語 | OpenAI Whisper | Naver CLOVA Speech | 8-12% CER |
| ヒンディー語 | Azure Speech | Azure Speech | 9-14% WER |
| タイ語 | Google Cloud STT Chirp | Google Cloud STT Chirp | 18-26% WER |
| ベトナム語 | Google Cloud STT Chirp | Google Cloud STT Chirp | 15-22% WER |
| インドネシア語 | OpenAI Whisper | Google Cloud STT Chirp | 未公開 |
| タミル語 | Azure Speech | Azure Speech | 未公開 |
| ベンガル語 | Azure Speech | Azure Speech | 未公開 |
| タガログ語/フィリピン語 | Google Cloud STT Chirp | Google Cloud STT Chirp | 未公開 |
CER数値はVexaScribeベンチマーク(2026年6月検証)から引用。WER数値も同じソースから。「未公開」は、本稿執筆時点で独立したベンチマークが見つからなかったことを意味します。
コードスイッチングで実際に機能するもの
コードスイッチングは多くのアジアの会話で標準的です。ヒンディー語英語(Hinglish)、シンガポール英語にマレー語と北京語が混ざるシングリッシュ(Singlish)、タガログ語英語(Taglish)、マレーシア英語にマレー語が混ざるマングリッシュ(Manglish)はすべて、文の途中での切り替えを伴います。
手動設定なしでコードスイッチングを処理できるツール:
- OpenAI Whisper: 主要言語を設定します。モデルは両方の言語コードを宣言しなくても、切り替えを自動で処理します。これはヒングリッシュやタグリッシュに対して最も信頼性の高いアプローチです。
- Google Cloud STT v2: APIに明示的なコードスイッチング設定オプションがあり、事前に2つの言語が分かっている場合に便利です。
- AssemblyAI Universal: 自動言語検出がコードスイッチングされたコンテンツをある程度カバーします。
苦戦するツール: 厳格な単一言語の宣言を要求し、信頼度フィルタリングでそれを強制するエンジンは、切り替えられたセグメントを幻覚したり、落としたりします。
アジア言語の文字起こしにおける実践的なワークフロー
- 言語を特定し、上記の表を確認して、ツールやワークフローに着手する前に現実的な精度の期待値を設定します。
- 中国語(マンダリン)の場合: Alibaba Cloud Model StudioまたはOpenAI Whisper。日本語・韓国語の場合: OpenAI Whisper。インドの言語の場合: Azure Speech。東南アジアの場合: Google Cloud STT Chirp。
- 文字起こし後、固有名詞、ブランド名、地名を最初に確認します。これらは、全体的なCERに関係なく、すべてのアジア言語エンジンで最もエラー率が高いカテゴリです。
- コードスイッチングされたコンテンツの場合、ファイルを分割せずにモデルに自動検出させます。分割すると、チャンクが単語の途中で終わり、境界エラーが発生することがよくあります。
- 公開するコンテンツの場合、ネイティブスピーカーによる最終チェックを行います。AIが大部分を処理し、人間のチェックが出版品質へのギャップを埋めます。
これらの言語で複数話者の分離が必要な場合は、話者ダイアライゼーションの解説ガイドも参照してください。ダイアライゼーションは言語サポートとは直交する機能であり、ツールによって異なります。
アジア言語におけるAPIとエンドユーザーツールの比較
開発者向けには、製品を構築する場合、選択肢はOpenAI Whisper($0.003-0.006/分)、Google Cloud STT Chirp($0.004-0.016/分、バッチかリアルタイムかによる)、AssemblyAI Universal($0.15/時間)、Azure Speech($0.18-1.00/時間、モードによる)の間になります。開発者向けの詳細な内訳は、音声認識APIの料金比較をご覧ください。
エンドユーザー向けに、何も構築せずにファイルを文字起こししたい場合は、これらの言語を標準でサポートするWebインターフェースを備えたツールを利用してください。アカウントを作らずにファイルを処理したいなら、ConvertAudioToTextは主要なアジア言語に対応し、即時アップロードが可能です。アカウントなしでどのファイルも最初の30分は無料で、無料アカウントなら1日30ファイルまで、各30分までのファイルを文字起こしでき、Proプランは月額$14.99で無制限の文字起こしが可能です。
アジア言語では避けるべきツール
それ以外にも有能なツールがいくつかありますが、アジア言語のサポートが弱く、この用途には適していません。
- Otter、Rev、Trint: 英語優先のツールです。アジア言語のサポートは存在しますが、ベンダーのドキュメントによると主要な焦点ではなく、精度は一般的にWhisperベースの代替ツールより劣ります。
- Deepgram Nova-3: 英語とヨーロッパ言語には強いですが、Deepgramの公開ドキュメントによると、アジア言語のカバレッジは上記のオプションと比べて限定的です。API比較についてはDeepgram vs AWS Transcribeをご確認ください。
- AWS Transcribe: 限られたアジア言語セットをサポートしています。コミュニティのベンチマークでは、ほとんどのアジア言語でWhisperベースのツールより精度が低いとされていますが、AWSはCER比較を公開していません。
別の言語ファミリーに関する並行した文脈として、アフリカ言語に最適な文字起こしの投稿では、異なる過小評価された言語セットに対する同じエンジン対言語のトレードオフを扱っています。
FAQ
北京語(マンダリン中国語)に最適な文字起こしエンジンはどれですか?
SenseVoice(阿里巴巴FunAudioLLMのオープンモデル。Alibaba Cloud Model Studio経由で利用可能)は、普通話で10.78%のCERを達成しており、Whisper Large-v3の12.55%を上回ります。また、オーディオをリアルタイムの52〜118倍の速度で処理します。中国国外の開発者にとっては、OpenAI WhisperやGoogle Cloud STT Chirpが、シンプルなAPIアクセスを備えた堅実な代替案です。
Whisperはアジア言語をうまく処理できますか?
主要な言語については、はい。Whisper Large-v3は日本語と韓国語で8〜12%のCER、ヒンディー語で9〜14%のWER、普通話で12.55%のCERを達成しています。CER(文字誤り率)はCJK言語に適した指標です。なぜなら、単語の境界がスペースで区切られていないため、WERは誤解を招くからです。タイ語(18〜26% WER)とベトナム語(15〜22% WER)では性能が低下します。
アジア言語の文字起こしで最も安いAPIオプションは何ですか?
OpenAIのgpt-4o-mini-transcribeは1分あたり$0.003(1時間あたり約$0.18)で、主要なアジア言語をサポートしています。Whisper-1とgpt-4o-transcribeは1分あたり$0.006です。Google Cloud STT Chirpは、リアルタイムで1分あたり$0.016、バッチ処理(24時間以内の納品)で1分あたり$0.004です。AssemblyAIはUniversal-2で1時間あたり$0.15からですが、話者分離やその他のアドオンを含む実際の本番コストは通常、それより高くなります。
ヒングリッシュやタグリッシュのようなコードスイッチング音声で文字起こしが失敗するのはなぜですか?
ほとんどのエンジンは単一の言語を宣言することを想定しており、話者が文の途中で切り替えると失敗します。Whisper Large-v3は、両方の言語コードを宣言しなくてもコードスイッチングを自動的に処理します。主要言語を設定すれば、残りはモデルが処理します。Google Cloud STT v2には、明示的なコードスイッチング設定オプションがあります。ツールが単一言語の宣言を必要とする場合、主要言語を設定してモデルに残りを任せる方が、音声ファイルを分割するよりも良い結果が得られます。
Naver CLOVA SpeechとiFlytekはアジア国外でも利用できますか?
両方とも国際的なAPIを提供していますが、実際の利用しやすさは異なります。Naver CLOVA SpeechはNAVER Cloud Platformを通じて利用でき、英語のドキュメントが用意されており、韓国語、英語、日本語、簡体字中国語に対応しています。iFlytekのグローバルプラットフォーム(global.xfyun.cn)では英語を含む15以上の言語のAPIが掲載されていますが、価格が不透明で、通常は開発者アカウントが必要です。韓国や中国以外での本番利用には、WhisperベースのツールやGoogle Cloud STTの方がより簡単です。
出典
- OpenAI API料金(Whisper、gpt-4o-transcribe、gpt-4o-mini-transcribeの料金)
- Google Cloud Speech-to-Text V2対応言語(Chirpの言語リスト確認済み)
- Google Cloud Speech-to-Text料金(リアルタイム$0.016/分、バッチ$0.004/分)
- AssemblyAI料金(Universal-2は$0.15/時間、Universal-3.5 Proは$0.21/時間)
- AssemblyAI対応言語(日本語、韓国語、中国語(北京語)、ヒンディー語、タイ語、ベトナム語、インドネシア語を確認)
- SenseVoice GitHub(FunAudioLLM)(モデル説明、学習データ)
- SenseVoiceとWhisperのCJKベンチマーク(CER数値、速度比較は2026年6月に検証)
- Whisperの言語別精度(言語階層別のCER/WER数値)
- Alibaba Cloud Model Studio ASR(Fun-ASR 1.5 API)
- Naver CLOVA Speech概要(韓国語、英語、日本語、簡体字中国語の対応を確認)
- Azure Speech料金(リアルタイム$1/時間、バッチ$0.18/時間を確認)
- iFlytekグローバルプラットフォーム(言語リスト、料金モデル)
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
漢字対応の日本語文字起こし、2026年版ガイド
AIが漢字出力、分かち書きなしのトークン化、同音異義語の判別、敬語の丁寧さ、方言の正確さをどう扱うか。日本語文字起こしのツール比較付き。
韓国語文字起こしガイド:ハングル・敬語・コングリッシュ
2026年に韓国語音声を正確に文字起こしする方法:ハングルの分かち書き規則、敬語のスピーチレベル、コングリッシュの外来語、エンジンの対応レベル、実際に韓国語に対応しているツール。

ヒンディー語文字起こしとヒングリッシュの壁(2026年最新)
2026年におけるAIエンジンのヒングリッシュ(コードスイッチング)対応:デーヴァナーガリー文字対ラテン文字の出力比較、エンジン別の特徴、ヒンディー語・英語混在音声の実用的な対処法。
中国語文字起こし、簡体字・繁体字・声調のすべて
中国語(マンダリン)の文字起こし、簡体字と繁体字の出力、同音異義語、広東語の注意点、2026年のエンジン対応状況まで。
オランダ語とフラマン語の文字起こし、その違いの実態
オランダのオランダ語とベルギーのフラマン語で、ASRの精度がどう変わるか。tussentaalの現実、方言の難しさ、そしてnl-NLとnl-BEに実際に対応しているツールはどれか。
ケニアとタンザニア向けスワヒリ語文字起こし、2026年に使えるもの
スワヒリ語はアフリカ言語の中でASR対応が最も進んでいる。エンジン対応、シェング語のコードスイッチング、ケニアとタンザニアの方言差を解説。