
文字起こしの低信頼度(Low Confidence)とは?意味と修正方法
Summarize this article with:
文字起こしにおける「低信頼度(Low confidence)」とは、音声認識システムがその単語に確信を持てなかったことを意味します。 すべての単語には、システムが正しいと考える確率を示すスコア(通常は0から1の間)が付与され、しきい値を下回る単語には低信頼度のフラグが立てられます。このフラグは、それらが間違っているという証明ではなく、音声と照らし合わせてその箇所を確認するための警告です。ノイズ、クロストーク、訛り、珍しい名前や数字が主な原因です。
「文字起こしの低信頼度」が意味すること(わかりやすく言うと)
| 表示される状態 | 意味すること | 対処法 |
|---|---|---|
| 低信頼度の単語がいくつかある | システムが推測せざるを得なかった名前、数字、珍しい専門用語 | 該当する単語の音声を聞いて修正する |
| ひとまとまりの箇所全体が低信頼度になっている | ノイズ、距離、クロストークなど、音声自体が聞き取りにくい | 該当箇所を確認し、可能であれば録音環境を改善する |
| ファイル全体が低信頼度になっている | 言語設定の誤り、非常に悪い音質、または激しい発話の重なり | 手動で話し言葉の言語を設定し、再度文字起こしする |
| 全体的に高信頼度になっている | システムが確信を持っており、通常はクリアな音声であることを意味する | それでも名前、数字、同音異義語は確認する |
低信頼度の文字起こしを修正する方法
- フラグ付きの単語を最初にレビューする。 低信頼度の各箇所で音声を再生し、聞こえた通りに修正します。これにより、全文を読むのに比べてわずかな時間で実際のエラーの大部分を捕捉できます。
- 話し言葉の言語設定を確認する。 短いクリップや複数言語が混在するクリップでは、自動検出が間違った言語を選択することがあります。手動で設定してファイルを再実行してください。
- テキストだけでなく録音自体を修正する。 セクション全体が低信頼度である場合は、背景ノイズを減らし、マイクを近づけ、同時に話さないように依頼してください。詳細は文字起こし前に音質を改善する方法を参照してください。
- 話者名と専門用語を特定する。 珍しい名前や専門用語は、最も一般的な低信頼度の単語です。一度修正したら、トランスクリプト内で同じ間違いが他の場所にないか検索してください。
原因の完全なリストについては、文字起こしが間違える理由および文字起こしの精度を向上させる方法を参照してください。
スコアが実際に意味するもの
信頼度スコアとは、トランスクリプト内の特定の単語が正しいというエンジンの推定値を0から1の間の数値で表したものです。0.95のスコアは、モデルがその単語を正しく認識した確率が約95%と考えていることを意味します。0.42のスコアは、確信度がはるかに低かったことを意味します。
ほとんどの実稼働APIでは、スコアは単語レベルで存在します。たとえばDeepgramは、APIレスポンス内のすべての単語オブジェクトに対して単語ごとのconfidenceフィールドを返します。これは同社のドキュメントで「単語が正しく文字起こしされたとモデルが推定する確率を表す0から1の間の浮動小数点数」と定義されています。実際には、クリアな音声ではモデルがほとんどの単語に対して本当に確信を持っているため、クリーンなオーディオでは値が1.0付近に集中して表示されます。注目すべきシグナルは外れ値にあります。
Whisperのリファレンス出力は異なる仕組みで動作します。ネイティブでは単語ごとの信頼度を公開していません。代わりに、各セグメントがavg_logprob(セグメント全体の平均対数確率で、マイナスが大きいほど確信度が低いことを意味する)とno_speech_prob(そのウィンドウ中に誰も話していなかったというモデルの推定値)を持ちます。トークン確率の追加の後処理を行わない限り、Deepgramの単語ごとのスコアに直接相当するものはありません。Whisperをラップするツールはアライメントパスから単語レベルの推定値を導き出す場合がありますが、これらはネイティブの単語ごとの出力と同じではありません。
数値が見た目以上に扱いにくい理由
高信頼度は保証ではない
0.99の信頼度は、そのスコアの単語の約100個に1個が間違っていることを意味します。8,000語の1時間のトランスクリプトでは、「非常に高い信頼度」での1%のエラーでさえ約80個の間違いを生み出します。より大きなリスクは、最新のニューラルモデルが、特にノイズの多い条件下で体系的に過信する可能性があることです。2024年と2025年に発表された研究では、一部のASRモデルが低い信号対雑音比(SN比)において、0.70以上の信頼度でトークンの10〜20%を誤って予測することがわかりました。これは単一の製品の欠陥ではなく、モデルがキャリブレーション調整されていない場合にニューラルデコーダー内のソフトマックス確率がどのように振る舞うかを反映しています。
高信頼度の単語は最後にレビューすべきものですが、それでも間違っている可能性があります。
低信頼度はエラーの断定ではない
信頼度0.45の単語が完全に正しい場合もあります。 低信頼度は通常、モデルがいくつかの妥当な候補を検討し、僅差で1つを選んだことを意味します。エンジンがめったに見たことのない固有名詞、文脈が複数の値をサポートする数字、次の文で初めて曖昧さが解消される同音異義語が、最も一般的な低信頼度の単語です。それらが間違っていると決めつけるのではなく、音声と照らし合わせて確認してください。
スコアはエンジン間で比較できない
Deepgramの0.85と別のエンジンの0.85は同じ主張ではありません。 Deepgram自身のドキュメントでも直接的に述べられています。「信頼度スコアの定義とキャリブレーションはSTTプロバイダーによって異なります。プロバイダー間で生の信頼度分布を直接比較することはできません。」異なるエンジンは、異なる確率スケール、異なるキャリブレーション調整、そして時にはスコアが何を表すかについての異なる定義を使用しています。平均信頼度出力に基づいてエンジンを選択している場合、互換性のない数値を比較していることになります。
意味のあるエンジン比較には、同じ音声で両方を実行し、出力を手動で確認し、実際の単語誤り率(WER)を測定する必要があります。正しい方法については、文字起こし精度の解説を参照してください。
単語レベル vs セグメントレベル
単語レベルの信頼度は、個々の単語に数値を割り当てます。 不確実だった特定の単語に直接移動できるため、これはトランスクリプトをレビューする上で最も実用的な形式です。
セグメントレベルの信頼度は、フレーズまたは文のブロックに単一の数値を割り当てます。Deepgramのトランスクリプトレベルのスコアは、そのチャンク内の単語レベルの値の中央値です。Whisperのavg_logprobはセグメントレベルの対数確率です。どちらも長いトランスクリプトを流し読みして粗いセクションを見つけるのに役立ちますが、フラグが立てられたセグメント内のどの単語が問題であるかは教えてくれません。
実用的なレビュー作業には、単語レベルの方が優れたツールです。ルーティングの決定(このセグメントを人間のレビュアーに送るなど)には、セグメントレベルで十分な場合がよくあります。
キャリブレーション:その意味と重要性
キャリブレーション(較正)された信頼度スコアとは、数値が精度を正直に反映しているものです。エンジンが0.90とスコアリングしたすべての単語を集めてすべて確認した場合、正確に90%が正しいはずです。それがキャリブレーションです。Deepgramは、その特性を目標として、自社の単語信頼度を「キャリブレーションされた確率」と表現しています。
ほとんどのニューラルモデルは、そのままでは完全にキャリブレーションされていません。上限付近で過信する傾向があり、実際の精度が0.88に近いときに0.95と判定します。温度スケーリングやその他の事後処理技術でこれを改善できますが、それらを適用しているかどうか、またどのように適用しているかを公表している製品はほとんどありません。
信頼度の数値が完全に正直な確率であると仮定しないでください。 絶対的なものではなく、相対的なシグナルとして使用してください。さまざまな信頼度帯の単語のサンプルをレビューし、実際に正しい割合を確認することで、独自のデータで検証してください。結果として得られるキャリブレーション曲線は、特定の音声タイプにおいて各信頼度レベルが実際に何を意味するかを示します。強い訛りのあるインタビューは、同じエンジンであっても、スタジオ録音されたポッドキャストとは異なるキャリブレーション曲線を生成します。
実際の業務での信頼度スコアの活用
低から高へ並べ替えてレビューをトリアージする
長いトランスクリプトの場合、信頼度で単語を並べ替えるかフィルタリングし、最も信頼度の低いものから最初にレビューします。90分のトランスクリプトにおける実際のエラーの大部分は、0.70のしきい値を下回る数百語に集中しています。 それらの特定の単語を音声と照らし合わせてレビューすることで、最初から最後まで読む時間コストのほんの一部で、間違いの大部分を捕捉できます。
ほとんどの一般向け文字起こしツールは、これを色分けハイライトとして公開しています。低信頼度の単語が異なる色で表示され、クリックして確認できます。生のAPI出力を扱っている場合は、confidenceフィールドで単語リストをフィルタリングし、オーディオプレーヤーでそれらの単語のタイムスタンプをキューに入れます。
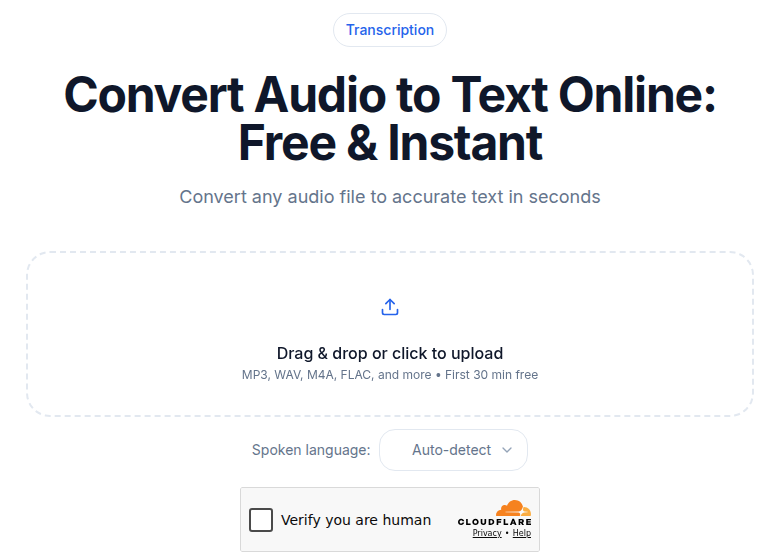 文字起こしとレビューを開始するConvertAudioToTextの音声アップロードツール
自動QAのしきい値を設定する
大量処理やコンプライアンス重視のワークフローでは、しきい値を設定し、それを下回るトランスクリプトや単語に自動的にフラグを立てて人間のレビューに回します。一般的な出発点は0.80または0.85ですが、適切な数値は音声タイプに対するキャリブレーションチェックの結果によって異なります。
モデルの不確実性シグナルは、組み込みの品質ゲートになります。これは、テキストが下流のシステムに送られる前にトランスクリプトの品質が定義された基準を満たす必要があるあらゆるパイプラインでうまく機能します。高品質なトランスクリプトを低コストで作成する要素の詳細については、信頼度を考慮したレビューが組み込まれている場合に実際に何に対して支払っているかを解説した料金に関する記事を参照してください。
下流システムで低信頼度の一致に重み付けする
トランスクリプトの上に検索や分析を構築している場合は、テキストを絶対的な真実(グラウンドトゥルース)ではなく、ノイズを含むシグナルとして扱います。0.45とスコアリングされた単語でのキーワード一致は、0.98での一致よりも重みを低くする必要があります。用語の出現回数をカウントする分析ダッシュボードは、信頼度の重み付けを考慮すべきです。そうしないと、1つの混乱した固有名詞が誤解を招く下流データへと伝播してしまいます。
信頼度スコアが捕捉できないもの
限界を知ることは、ユースケースを知ることと同じくらい重要です。
信頼度は、意味的に妥当な間違った単語を捕捉しません。 「affect」と「effect」、「principal」と「principle」、「your」と「you're」は、文脈が利用可能になって区別できるようになる前にエンジンが一方に確定してしまうため、高い信頼度で文字起こしされることがよくあります。これらはスコアがフラグを立てない実際のエラーです。
信頼度は、無音中のハルシネーション(幻覚)を捕捉しません。 無音区間中にモデルが幻のテキストを生成した場合、それらの幻の単語の信頼度は中程度かもしれませんが、単語は完全に捏造されたものです。これは単語の信頼度フィールドとは無関係の、独自の検出シグナルを持つ別の故障モードです。
信頼度は、話者ラベルの精度をカバーしません。 文字起こしの信頼度は単語に関するものです。Deepgramはダイアライゼーション結果のために事前録音された音声に対してspeaker_confidenceフィールドも返しますが、これは別のモデルからの別の数値です。2つのシグナルは独立しています。単語が正しく文字起こしされても間違った話者に帰属される可能性があり、どちらの信頼度フィールドもそれにフラグを立てません。話者信頼度の仕組みについては、話者ダイアライゼーションの解説を参照してください。
信頼度は、脱落した単語を捕捉しません。 モデルが単語をまったく文字起こしできなかった場合、それにフラグを立てる信頼度スコアは存在しません。欠落した単語は事後に検出するのが最も難しいエラーであり、信頼度スコアリングが対処する範囲外です。
エンジン間の信頼度:DeepgramとWhisperの比較
| シグナル | Deepgram | Whisper(リファレンス) |
|---|---|---|
| 単語ごとの信頼度 | あり、confidenceフィールド(0-1) | APIでネイティブに公開されていない |
| セグメントレベルのシグナル | トランスクリプト信頼度 = 単語スコアの中央値 | avg_logprob(負の浮動小数点数、マイナスが大きいほど不確実) |
| 無音検出 | 標準出力にno_speech_probはなし | セグメントごとのno_speech_prob |
| 話者信頼度 | speaker_confidence(事前録音のみ) | 利用不可 |
| しきい値ワークフローへの対応 | あり、後処理は不要 | 単語レベルには追加のアライメントツールが必要 |
信頼度を考慮したレビューや下流の重み付けを構築したいユーザーにとって、Deepgramの形式はより即座に実用的です。Whisperのavg_logprobはルーティングの決定(セグメント全体にフラグを立てる)には役立ちますが、単語ごとの値を生成するには追加のツールが必要です。Deepgramのエンジンが内部でどのように機能するかについては、Deepgram Nova-3の解説を参照してください。
私の見解:信頼度スコアを使ってできる最も有益なことは、しきい値を中心とした自動ワークフローを構築する前に、自身の音声のサンプルでキャリブレーションチェックを実行することです。あなたの素材における0.80の意味は、他の誰かの素材における意味とは異なり、音声条件が変化するにつれて曲線もシフトします。
よくある質問(FAQ)
文字起こしの「低信頼度(Low Confidence)」とはどういう意味ですか?
音声認識システムがその単語に確信を持てなかったことを意味します。各単語には正しい可能性を示すスコア(通常0から1の間)が付与されます。低信頼度は、ノイズ、クロストーク、訛り、珍しい名前、数字などが原因で、間違っている可能性が高い単語や箇所を示します。これはエラーの証明ではなく、音声を確認するための警告です。
低信頼度の文字起こしはどうすれば修正できますか?
フラグが立った箇所の音声を再生し、手動で単語を修正します。セクション全体が低信頼度の場合、録音自体に問題があります。背景ノイズを減らす、マイクを近づける、一度に1人ずつ録音する、または自動検出に頼らず手動で言語を設定してから再度文字起こしを行ってください。
音質は文字起こしの精度に影響しますか?
はい、他の何よりも大きく影響します。背景ノイズ、反響、マイクからの距離、低ビットレートの電話音声、複数人の同時発話はすべて精度を下げ、信頼度スコアを押し下げます。
文字起こしにおける良い信頼度スコアの目安は?
エンジンによって信頼度のスケールが異なるため、共通の基準はありません。単一のエンジン内では、0.80未満の単語は再確認する価値があり、0.60未満の単語はほぼ常にレビューが必要です。ただし、これらの数値は出発点であり保証ではありません。0.99の単語が間違っていることもあれば、0.55の単語が正しいこともあります。
DeepgramやWhisper、その他のエンジンの間で信頼度スコアを比較できますか?
いいえ。Deepgramのドキュメントには、信頼度の定義とキャリブレーションはプロバイダーによって異なり、生のスコアを直接比較することはできないと明記されています。Deepgramの0.85と他のエンジンの0.85は、精度に関して同じ主張をしているわけではありません。
高信頼度の単語が間違っていることがあるのはなぜですか?
モデルは完全な文脈が利用可能になる前に、トークンごとに単語を確定させます。音響的に類似した単語(英語の「affect」と「effect」、「principal」と「principle」など)は、間違った方が選ばれた場合でも、モデルがそれらを曖昧だと見なさなかったために高い信頼度スコアになることがあります。ノイズ下での過信もASR研究でよく知られています。
信頼度スコアが低いということは、その単語が間違っているという意味ですか?
必ずしもそうではありません。低信頼度は、モデルが複数の妥当な候補を検討し、選ばれたものが僅差で勝ったことを示しています。勝者が正しい可能性もあります。最も一般的な低信頼度の単語は、周囲の文脈だけでは明確な勝者を確定できなかった固有名詞、数字、同音異義語です。
ご自身の録音を確認するには、ConvertAudioToTextの音声テキスト変換ツールをご利用ください。アカウント不要でファイルの最初の30分間を無料で文字起こしでき、タイムスタンプを使って音声内の疑わしい箇所にすぐにジャンプできます。
出典
- Deepgram Confidence Documentation: 定義、キャリブレーションの主張、プロバイダー間の注意事項(2026-10-14確認)
- Deepgram Diarization Documentation - 事前録音出力における
speaker_confidenceフィールド(2026-07-02確認) - OpenAI Whisper verbose_json fields - セグメントレベルの
avg_logprobとno_speech_probの確認、ネイティブの単語ごとの信頼度なし(2026-07-02確認) - ASR Confidence Score Evaluation, arXiv 2503.15124 - 信頼度を用いた自動エラー検出、2025年
- ICLR 2024 paper on ASR confidence calibration - ニューラルモデルにおける過信の挙動
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
AIが低リソース言語で苦戦する理由、2026年の正直な現状
学習データの不足、声調の複雑さ、ベンチマークの欠如が、低リソース言語の文字起こし精度のギャップを生んでいます。2026年時点の正直な状況と、改善している点を解説します。
音質の悪い音声を文字起こしする:何が救えるのか(2026)
劣化した音声の文字起こしに関する現実的なガイド:カセットテープ、スピーカーフォン通話、遠くのマイク。AIが対応できること、効果のある準備、人間に依頼すべきタイミング。
文字起こし精度の解説、99%が実際に意味するもの
95%の文字起こし精度が実際にどういうことか、WERの計算、ベンチマークのトリック、精度帯ごとの編集時間まで解説。
文字起こし前の音声品質改善:効果があること
アップロード前に効果のある処理チェーン(モノラル化、ノーマライズ、ノイズ除去)と、正直に言えば時間の無駄になるステップ。