
Transkription von Forschungsinterviews: Ein qualitativer Leitfaden für 2026
Summarize this article with:
Um Forschungsinterviews zu transkribieren, legen Sie vor der Aufnahme Ihre Transkriptionsebene fest, holen Sie eine schriftliche Einwilligung ein, die erklärt, wie das Audio transkribiert wird, lassen Sie die Aufnahmen für einen ersten Entwurf mit Sprechererkennung durch ein KI-Tool laufen, prüfen Sie jedes Transkript anhand der Audiodatei, anonymisieren Sie in einem separaten Durchgang und importieren Sie die TXT- oder DOCX-Dateien in NVivo, MAXQDA oder ATLAS.ti. Planen Sie 1,5 bis 2,5 Stunden Prüfzeit pro Stunde Interview-Audio ein, gegenüber 4 bis 6 Stunden für das manuelle Abtippen. Für die thematische Analyse reicht meist ein geglättetes Transkript; Konversations- und Diskursanalysen benötigen eine wörtliche Transkription.
Um ein Forschungsinterview zu transkribieren, legen Sie Ihre Transkriptionsebene fest, nehmen mit schriftlicher Einwilligung auf, erstellen einen ersten KI-Entwurf mit Sprechererkennung, prüfen diesen anhand des Audios, anonymisieren ihn und importieren ihn dann in Ihre Analysesoftware. Eine Stunde Interview von Hand abzutippen dauert 4 bis 6 Stunden. Mit einem KI-Entwurf dauert eine sorgfältige Prüfung etwa 1,5 bis 2,5 Stunden. Diese Überprüfung ist keine verlorene Zeit: In den meisten qualitativen Traditionen ist sie Ihre erste intensive Lektüre des Datenmaterials.
Dieser Leitfaden behandelt den gesamten Ablauf für Interviews, Fokusgruppen und aufgezeichnete Vorlesungen, von der Einwilligung bis zum Import in NVivo, einschließlich der Entscheidungen, nach denen Ihre Betreuung oder Gutachtende fragen werden.
Kurzantwort: Der Ablauf bei der Transkription von Forschungsinterviews
| Phase | Was Sie tun | Warum das wichtig ist |
|---|---|---|
| 1. Einwilligung und Setup | Schriftliche Einwilligung für Aufnahme, Transkriptionsweg, Speicherung und Aufbewahrung | Ethikkommissionen behandeln die Aufnahmeeinwilligung als eigene Angabe |
| 2. Transkriptionsebene | Wörtlich oder geglättet, einmalig für die gesamte Studie festgelegt | Ein Wechsel mitten im Projekt verhindert den fallübergreifenden Vergleich |
| 3. Erster KI-Entwurf | Stapel-Upload mit aktivierter Sprechererkennung | Minuten pro Datei statt Stunden |
| 4. Überprüfung | Transkript mitlesen, während das Audio läuft | Falsche Wörter führen zu falschen Codes |
| 5. Transkriptionsregeln | Sprecher-Labels, Pausen- und nonverbale Marker, Zeitstempel | Einheitlichkeit erlaubt automatisches Codieren nach Sprechenden |
| 6. Anonymisierung | Identifikatoren in einem eigenen Durchgang ersetzen, Protokoll führen | Schützt Teilnehmende und Ihr Ethikvotum |
| 7. Import und Speicherung | TXT oder DOCX in NVivo, MAXQDA oder ATLAS.ti; Speicherung nach Protokoll | Nachvollziehbarkeit (Audit-Trail) für die Publikation |
Transkriptionsebenen: Wofür Sie sich eigentlich entscheiden
Es gibt drei Detailstufen bei der Transkription, und wer sie vermischt, bekommt später Probleme.
Wörtliche Transkription (True Verbatim) erfasst jedes Wort genau so, wie es gesprochen wurde: Füllwörter ("äh", "wissen Sie", "sozusagen"), Satzabbrüche, wiederholte Phrasen und nonverbale Äußerungen wie Lachen, lange Pausen und Seufzen. Das Transkript sieht unruhig aus. Es ist aber das einzige Format, das Konversationsanalyse, Diskursanalyse und narrative Forschung unterstützt, bei denen das Wie des Gesagten die Argumentation trägt.
Geglättete Transkription (Intelligent Verbatim), auch bereinigte Transkription oder Clean Verbatim genannt, behält den vollen Inhalt und die Bedeutung bei, entfernt aber Füllwörter, Satzabbrüche und redundante Wiederholungen und glättet die Grammatik leicht. Dies ist der Standard für die thematische Analyse, die qualitative Inhaltsanalyse, die Grounded Theory und die meiste Politikforschung. Es ist das, was die meisten Forschenden meinen, wenn sie von "Transkription" sprechen.
Zusammenfassende Transkription (Summary Transcription) verdichtet das Interview auf Kernaussagen. Sie eignet sich für Machbarkeitsstudien und eine erste Orientierung, nicht aber für die Primäranalyse, da sie die Interpretation der transkribierenden Person vor Ihre eigene stellt.
Wenn Sie unsicher sind, welche Ebene Ihre Methode benötigt, wählen Sie die wörtliche Transkription. Sie können ein wörtliches Transkript später immer noch glätten. Aus einem geglätteten Text lassen sich Füllwörter und Pausen jedoch nicht wiederherstellen, ohne erneut in das Audio hineinzuhören.
Die Konversationsanalyse geht noch weiter und legt das Jefferson-Transkriptionssystem (Timing, Überlappungen, Tonhöhe, Prosodie) über das wörtliche Transkript. Kein aktuelles KI-Tool kann das erzeugen; nutzen Sie die KI daher für den ersten Durchgang und fügen Sie die Notation von Hand ein.
Methodenspezifische Genauigkeitsstandards
| Methode | Transkriptionsebene | Genauigkeitsanforderung | Hinweise |
|---|---|---|---|
| Konversationsanalyse | Wörtlich + Jefferson-Notation | Nahezu perfekt | KI-Entwurf ist nur ein Ausgangspunkt |
| Diskursanalyse | Wörtlich | Hoch, menschliche Prüfung Pflicht | Pausenlänge und Überlappungen sind relevant |
| Narrative Forschung | Wörtlich | Hoch | Wie die Geschichte erzählt wird, ist Teil der Daten |
| Grounded Theory | Geglättet | Mittel bis hoch | Codiert wird Zeile für Zeile, ein falsches Wort ergibt einen falschen Code |
| Thematische Analyse | Geglättet | Mittel | Gute Lesbarkeit hilft beim Vertrautwerden mit dem Material |
| Qualitative Inhaltsanalyse | Geglättet | Mittel | Fehler verändern Häufigkeitszählungen |
| Phänomenologie | Geglättet mit wörtlichen Passagen | Mittel | Beschreibungen gelebter Erfahrung exakt beibehalten |
Die reflexive thematische Analyse nach Braun und Clarke betrachtet das Vertrautwerden mit den Daten als erste Phase der Analyse, nicht als bloße Vorbereitung darauf. Das Überprüfen eines KI-Transkripts anhand der Audiodatei ist genau diese Einarbeitungsarbeit. Mehr zu den einzelnen Methoden finden Sie unter thematische Analyse aus Transkripten, qualitative Interviews codieren und Transkription für die Grounded Theory.
Phase 1: Einwilligung und Aufnahme-Setup
Teilnehmende müssen der Aufnahme schriftlich zustimmen, bevor Sie auf Aufnahme drücken. Die Einwilligung zur Tonaufnahme ist eine separate, ausdrückliche Erklärung und kein Nebensatz, der in einer allgemeinen Studienvereinbarung versteckt ist. Ihr Formular sollte folgende Punkte abdecken:
- Dass das Interview als Audiodatei aufgezeichnet wird
- Wer es transkribiert: Ihr Team, ein Dienstleister oder ein KI-Tool
- Wo Aufnahmen und Transkripte gespeichert werden und wer darauf zugreifen kann
- Wie lange die Aufnahmen vor der Löschung aufbewahrt werden
- Ob die Teilnehmenden das Transkript zur Prüfung zurückerhalten (Member Checking)
Die KI-gestützte Transkription in der Einwilligungserklärung ausdrücklich zu nennen, ist der sicherere Weg, selbst wenn Ihre Hochschule dies noch nicht zwingend vorschreibt. Senden Sie das Formular vor dem Interview per E-Mail zu, damit die Teilnehmenden es in Ruhe lesen können und Sie einen datierten Nachweis haben.
Bei der Aufnahme schlägt ein dediziertes Aufnahmegerät nah an der sprechenden Person jedes Laptop-Mikrofon, und ein Smartphone, das als Backup mitläuft, hat schon viele Studien gerettet. Testen Sie den Pegel vorab. Nehmen Sie in WAV oder als MP3 mit mindestens 128 kbps auf; die Raumakustik ist wichtiger als das Dateiformat. Benennen Sie jede Datei sofort mit einem Teilnehmendencode und dem Datum, zum Beispiel P01_2026-05-15.mp3, damit sie sich den Einwilligungsformularen zuordnen lässt, ohne die Identität preiszugeben.
Phase 2: Transkriptionsebene und Regeln festlegen
Wählen Sie die Transkriptionsebene aus dem obigen Abschnitt und schreiben Sie einen einseitigen Leitfaden (Transkriptionsregeln), bevor die erste Datei verarbeitet wird:
- Sprecher-Labels:
Interviewer:undP03:, in jedem Transkript im exakt gleichen Format - Pausenmarker, falls Ihre Methode sie erfordert:
[Pause],[lange Pause] - Nonverbale Elemente:
[lacht],[seufzt],[wird emotional] - Unverständliche Passagen:
[unverständlich 23:45]oder[unklar: "irgendetwas über die Förderung"], wenn Sie einen Teil verstehen. Raten Sie niemals. - Zeitstempel bei jedem Sprecherwechsel oder in festen Intervallen
Wenn die Interviews 1 bis 10 wörtlich und die Interviews 11 bis 20 geglättet transkribiert sind, behandelt Ihre Analysesoftware sie als gleichwertige Dokumente, obwohl sie es nicht sind.
Phase 3: Den ersten KI-Entwurf erstellen
Laden Sie das gesamte Korpus gesammelt hoch statt jede Datei einzeln, und aktivieren Sie die Sprechererkennung. Sprecher-Labels sind wichtig, weil die Interviewanalyse davon abhängt zu wissen, wer was gesagt hat. Lesen Sie unter Sprecherdiarisierung erklärt nach, wie die Erkennung funktioniert und wo sie an Grenzen stößt.
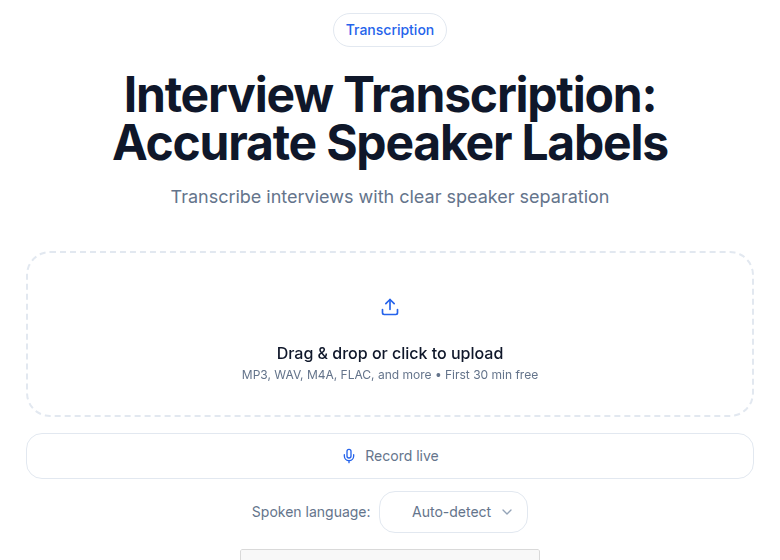 Laufende Interview-Transkription in ConvertAudioToText
Stellen Sie vor der Verarbeitung die Interviewsprache ein, falls es nicht Englisch ist. Die Genauigkeit sinkt stark, wenn die falsche Sprache gewählt wird. Ein 60-minütiges Interview ist in der Regel nach wenigen Minuten fertig. Die Genauigkeit ist hoch bei klarem Audio in einem ruhigen Raum und geringer bei Akzenten, Fachvokabular, gleichzeitigem Sprechen und emotional aufgeladener Sprache, die Teilnehmende oft sehr leise äußern. Unter Transkriptionsgenauigkeit erklärt finden Sie realistische Erfahrungswerte.
Phase 4: Jedes Transkript anhand der Audiodatei prüfen
Dies ist der Schritt, den die meisten Forschenden unterschätzen, und ihn zu überspringen ist der häufigste methodische Fehler in der KI-gestützten qualitativen Forschung. Spielen Sie das Audio mit 1,0- bis 1,25-facher Geschwindigkeit ab, während Sie mitlesen, und korrigieren Sie fortlaufend. Achten Sie besonders auf:
- Fach- oder Szene-Begriffe, die Ihre Teilnehmenden selbstverständlich nutzen. Legen Sie vorab ein Glossar an und korrigieren Sie diese Begriffe systematisch.
- Eigennamen: Personen, Organisationen, Orte und kulturelle Referenzen werden von der KI oft phonetisch geraten.
- Leise oder emotionale Passagen: Sie sind für die KI am schwersten zu erfassen und analytisch oft am wichtigsten.
- Überlappungen: Prüfen Sie, wer welche Zeile tatsächlich gesagt hat, besonders in Fokusgruppen.
Eine gründliche Überprüfung dauert etwa 1,5 bis 2,5 Stunden pro Stunde Audio, verglichen mit 4 bis 6 Stunden für das manuelle Abtippen. Bei 20 Interviews spart das rund 60 bis 80 Stunden. Wenn mehrere Personen prüfen, lassen Sie zwei davon denselben 15-minütigen Abschnitt kontrollieren und vergleichen Sie das Ergebnis: Die Abweichungen zeigen Ihnen, wo Ihre Transkriptionsregeln noch präziser gefasst werden müssen.
Fokusgruppen, Vorlesungen und Korpora für Abschlussarbeiten
Die Transkription von Fokusgruppen ist schwieriger als bei Einzelinterviews, weil Personen durcheinanderreden. Stellen Sie das Mikrofon in die Mitte des Tisches, bitten Sie alle, vor ihrem ersten Beitrag ihren Teilnehmendencode zu nennen, und benennen Sie die Sprecher-Labels im Editor einmalig um, sodass jede Zeile aktualisiert wird. Planen Sie mehr Prüfzeit ein und kontrollieren Sie jede Überlappung anhand des Audios.
Die Transkription von Vorlesungen für Forschungszwecke (Unterrichtsbeobachtung, aufgezeichnete Seminare) erfordert meist eher ein geglättetes Transkript und Zeitstempel als eine detaillierte Sprecherunterscheidung. Lange Aufnahmen sind in den kostenpflichtigen Tarifen kein Problem: Links und Videos können jeweils bis zu 24 Stunden lang sein.
Die Transkription für eine Dissertation umfasst meist 20 bis 30 Interviews à 45 bis 75 Minuten, also 15 bis 38 Stunden Audio. Verarbeiten Sie das gesamte Korpus mit denselben Einstellungen und Regeln, damit Ihre Daten konsistent bleiben.
Phase 5: In einem separaten Durchgang anonymisieren
Die meisten Studienprotokolle verlangen eine De-Identifizierung vor Beginn der Analyse. Die wichtigste Ausnahme ist die Oral History, bei der Zeitzeuginnen und Zeitzeugen oft namentlich genannt werden möchten.
Anonymisierung und Pseudonymisierung sind zwei verschiedene Dinge. Die Anonymisierung entfernt Identifikatoren dauerhaft; nach der DSGVO gelten vollständig anonymisierte Daten nicht mehr als personenbezogene Daten. Die Pseudonymisierung ersetzt Identifikatoren durch Codes ("P04" oder "Maya"), während eine Zuordnungsliste (Schlüssel) weiterhin existiert, sodass die Daten weiterhin dem Datenschutz unterliegen. Die meisten qualitativen Studien pseudonymisieren.
Ersetzen oder verändern Sie:
- Vollständige Namen, auch von Personen, die im Interview nur erwähnt werden
- Adressen, genannte Institutionen und identifizierbare Orte
- Berufsbezeichnungen, die spezifisch genug sind, um jemanden im Kontext zu erkennen
- Zeitangaben, die in Kombination mit anderen Details Rückschlüsse auf die Identität zulassen
- Alles, was die teilnehmende Person ausdrücklich als vertraulich ("off the record") eingestuft hat
Führen Sie ein Anonymisierungsprotokoll darüber, was Sie wodurch ersetzt haben, und bewahren Sie es getrennt von den Transkripten auf. Dies als eigenen Arbeitsschritt durchzuführen funktioniert besser als nebenbei während der Audioprüfung, weil Ihre Aufmerksamkeit dann ganz auf dem Identifizierungsrisiko statt auf der Wortgenauigkeit liegt. Weitere Details zu den rechtlichen und ethischen Rahmenbedingungen finden Sie unter Ethik der Interview-Transkription.
Phase 6: Import in NVivo, MAXQDA oder ATLAS.ti
Alle drei Programme importieren reine Text- und DOCX-Transkripte, und alle drei tauschen komplette Projekte über das REFI-QDA-Format (.qdpx) aus, falls Sie mitten im Projekt die Software wechseln müssen. Behalten Sie die Dateinamen bei, die Sie beim Upload verwendet haben, und importieren Sie die Dateien gesammelt. Einheitliche Sprecher-Labels ermöglichen Ihnen das automatische Codieren nach Sprechenden. NVivo verkauft auch ein eigenes Transkriptions-Add-on; der Leitfaden NVivo vs. KI-Transkription vergleicht beide Wege.
Phase 7: Speicherung und Aufbewahrung nach Studienprotokoll
Ihre Ethikkommission (bzw. Ihr IRB) verlangt einen dokumentierten Plan darüber, wie lange Sie Aufnahmen, Transkripte und Einwilligungserklärungen aufbewahren und wie diese jeweils vernichtet werden. Viele US-Institutionen setzen mindestens drei Jahre nach Studienabschluss für Forschungsunterlagen an, während staatliche Förderprogramme in den USA oft längere Fristen vorschreiben. Da Audioaufnahmen die Stimme der Teilnehmenden enthalten, bergen sie ein höheres Risiko als de-identifizierte Transkripte; viele Ethikkommissionen empfehlen daher, die Audiodateien zu löschen, sobald die Transkripte verifiziert sind.
- Verschlüsseln Sie gespeicherte Dateien und beschränken Sie den Zugriff auf das Forschungsteam.
- Nutzen Sie Server Ihrer Hochschule oder einen für die Forschung zugelassenen Cloud-Dienst, keine privaten Endgeräte.
- Bewahren Sie identifizierbare Daten getrennt von de-identifizierten Daten auf.
- Dokumentieren Sie Speicherort, Zugriffsliste, Aufbewahrungsfrist und Löschmethode in Ihrem Ethikantrag.
Notieren Sie für jeden Anbieter von KI-Transkription in Ihrem Antrag: ob Audiodateien nach der Verarbeitung gespeichert bleiben und wie lange, ob Inhalte zum Trainieren von Modellen verwendet werden, wo die Daten verarbeitet werden und ob ein Auftragsverarbeitungsvertrag (AVV / DPA) verfügbar ist.
Die Fakten für ConvertAudioToText, die Sie zitieren können: Dateien werden bei der Übertragung (TLS 1.2 oder neuer) und im Ruhezustand (AES-256) verschlüsselt; kein Mensch sieht Kundeninhalte ein; im kostenlosen Tarif wird das Quellaudio automatisch gelöscht, in der Regel etwa 7 Tage nach der Verarbeitung; in kostenpflichtigen Tarifen wählen Sie selbst, wie lange das Audio aufbewahrt wird (7, 30, 90 oder 180 Tage, 1 Jahr oder unbegrenzt); Transkripte bleiben im Konto, bis Sie sie löschen. ConvertAudioToText ist nicht nach SOC 2 zertifiziert, und ein BAA (für US-Gesundheitsdaten) erfordert eine individuelle Absprache mit dem Team. Details finden Sie auf der Sicherheitsseite und in der Liste der Unterauftragsverarbeiter.
Was es kostet, die Interviews einer Dissertation zu transkribieren
Nehmen wir 25 Interviews von jeweils etwa einer Stunde Länge, also 25 Stunden Audio.
| Weg | Direkte Kosten | Ihr Zeitaufwand |
|---|---|---|
| Selbst abtippen | $0 | 100 bis 150 Stunden |
| Menschlicher Service bei Rev für $1,99 pro Minute | ca. $2.985 | Nur Stichproben |
| KI-Entwurf + Ihre Prüfung mit ConvertAudioToText Pro | 14,99 $ für einen Monat | 38 bis 63 Stunden Prüfzeit |
| KI-Entwurf + Ihre Prüfung mit dem Weekly Pass | 9,99 $ pro Pass (1.200 Minuten, 7 Tage), also zwei Pässe für 25 Stunden | 38 bis 63 Stunden Prüfzeit |
Der Preis für die menschliche Transkription bei Rev stammt von rev.com/pricing, geprüft am 14. Oktober 2026.
Der hybride Weg ist weit verbreitet: KI für den Großteil der Interviews, ein menschlicher Schreibdienst für die drei oder vier Aufnahmen mit der schlechtesten Tonqualität oder der höchsten Sensibilität. Bei sehr intensiver Nutzung im Pro-Tarif, oberhalb von etwa 30 Stunden Audio innerhalb von 30 Tagen, kann die Verarbeitung über die Standard-Engine laufen. Einen breiteren Marktüberblick finden Sie unter Kosten der Transkription pro Stunde.
Qualitätssicherung, die sich lohnt
Member Checking (kommunikative Validierung). Das Gütekriterien-Modell von Lincoln und Guba (1985) nennt die Rückgabe von Transkripten an die Teilnehmenden als Technik zur Sicherung der Glaubwürdigkeit. In der Phänomenologie und der Grounded Theory ist dies üblich, in der Konversationsanalyse weniger.
Audit-Trail. Dokumentieren Sie das verwendete Tool, wer welches Transkript geprüft hat, die angewandten Transkriptionsregeln und jede Ermessensentscheidung bei schwer verständlichen Audiostellen.
Drei Fehler, die sich durch die gesamte Analyse ziehen
Das KI-Transkript als Primärquelle behandeln. Die Audiodatei ist die eigentliche Quelle. Ein falsches Wort in einem Zitat wird zu einem falschen Code und später zu einem verzerrten Thema.
Uneinheitliche Transkriptionsregeln im Projektverlauf. Legen Sie die Regeln vor der ersten Datei fest und wenden Sie sie auf jedes einzelne Transkript an.
Die Anonymisierung überspringen. Transkripte mit Klarnamen in geteilten Cloud-Ordnern, die ungeschwärzt an Betreuende geschickt oder archiviert werden, können gegen Einwilligungserklärungen sowie, sofern anwendbar, gegen die DSGVO oder Ihr Ethikprotokoll verstoßen.
Wie Sie starten
Sie können die ersten 30 Minuten eines Interviews kostenlos und ohne Konto transkribieren, um zu testen, wie Ihre eigenen Aufnahmen verarbeitet werden. Ein kostenloses Konto transkribiert bis zu 30 Dateien pro Tag mit jeweils bis zu 30 Minuten Länge, inklusive Sprechererkennung und TXT-Download; die allererste Datei darf dabei bis zu einer Stunde lang sein und enthält auch den DOCX-Export. Für Interviews in voller Länge und alle Exportformate decken der Weekly Pass oder das Pro-Abo ein ganzes Forschungskorpus ab. Weitere Informationen für Hochschulen finden Sie auf unserer Seite für Forschung und Lehre.
Häufig gestellte Fragen (FAQ)
Wie transkribiert man ein Forschungsinterview am besten?
Erstellen Sie einen ersten KI-Entwurf mit Sprechererkennung und prüfen Sie diesen anhand der Audiodatei, bevor Sie mit dem Codieren beginnen. Legen Sie vorab die Transkriptionsebene fest, nutzen Sie in jedem Transkript dieselben Regeln und anonymisieren Sie in einem eigenen Arbeitsschritt. Ein ungeprüftes KI-Transkript ist ein Entwurf, keine Datengrundlage.
Was ist eine geglättete Transkription (Intelligent Verbatim)?
Die geglättete Transkription, im Englischen oft Intelligent Verbatim oder Clean Verbatim genannt, behält alles bei, was gesagt und gemeint wurde, entfernt aber Füllwörter (äh, ähm, also), Satzabbrüche und Wortwiederholungen und glättet die Grammatik leicht für eine bessere Lesbarkeit. Sie ist der Standard für die thematische Analyse, die qualitative Inhaltsanalyse und die Grounded Theory. Die wörtliche Transkription (True Verbatim) behält jedes Füllwort, jede Pause und jede Überlappung bei und wird für Konversations- und Diskursanalysen benötigt.
Kann ich KI-Transkription für qualitative Forschung nutzen?
Ja, mit einem verbindlichen Prüfschritt. KI liefert in wenigen Minuten einen brauchbaren Entwurf eines 60-minütigen Interviews. Die Genauigkeit ist bei klarem Audio hoch und sinkt bei gleichzeitigem Sprechen, starken Akzenten, Hintergrundgeräuschen sowie leiser oder emotionaler Sprache. Jedes Zitat, das Sie veröffentlichen, sollte anhand der Aufnahme überprüft werden.
Wie lange dauert es, ein einstündiges Interview zu transkribieren?
Das manuelle Abtippen dauert in der Regel 4 bis 6 Stunden. Mit einem KI-Entwurf dauert eine sorgfältige Überprüfung anhand des Audios etwa 1,5 bis 2,5 Stunden pro Audiostunde, bei sauberen Aufnahmen auch weniger.
Wie transkribiere ich eine Fokusgruppe?
Nehmen Sie mit einem Mikrofon in der Tischmitte auf, bitten Sie die Teilnehmenden zu Beginn, vor dem Sprechen ihren Namen oder Code zu nennen, und lassen Sie die Stimmen durch die Sprechererkennung trennen. Planen Sie mehr Prüfzeit ein als bei einem Einzelinterview, da Personen durcheinanderreden. Benennen Sie die Sprecher-Labels einmalig in Teilnehmendencodes um und prüfen Sie dann jede Überlappung anhand der Aufnahme.
Wie gebe ich die KI-Transkription im Methodenteil an?
Schreiben Sie, dass die ersten Transkripte mit einer KI-Transkriptionssoftware erstellt wurden und dass das Forschungsteam jedes Transkript anhand des Originalaudios überprüft und korrigiert hat. Einige Fachzeitschriften und Ethikkommissionen fragen inzwischen ab, wie KI-Tools mit Teilnehmendendaten umgehen; folgen Sie hier den aktuellen Richtlinien Ihrer Institution und nennen Sie das Tool, falls gefordert.
Muss ich Transkripte vor der Analyse anonymisieren?
Meistens ja. Ersetzen Sie Namen, Orte, Arbeitgeber, Daten und spezifische Details, die eine Person identifizieren könnten, in einem separaten, dokumentierten Durchgang. Bewahren Sie den Schlüssel, der Pseudonyme mit echten Identitäten verknüpft, getrennt von den Transkripten und mit eingeschränktem Zugriff auf.
Welche QDA-Software funktioniert mit KI-Transkripten?
NVivo, MAXQDA und ATLAS.ti importieren alle reine Text- und DOCX-Transkripte und tauschen ganze Projekte über das REFI-QDA-Format (.qdpx) aus. Wählen Sie das Programm, das Ihre Hochschule lizenziert hat und das zu Ihrer Methode passt.
Wie lange sollte ich Interviewaufnahmen und Transkripte aufbewahren?
Viele US-Institutionen schreiben eine Mindestaufbewahrungsfrist von drei Jahren nach Studienabschluss für Forschungsunterlagen vor, und Fördergeber verlangen oft längere Fristen. Da Audioaufnahmen ein höheres Risiko bergen als anonymisierte Transkripte, empfehlen viele Ethikkommissionen, die Audiodateien zu löschen, sobald die Transkripte geprüft sind. Maßgeblich sind Ihr Ethikvotum, die Vorgaben der Fördergeber und die Richtlinien Ihrer Einrichtung.
Quellen
- Rev Preise: menschliche Transkription $1,99 pro Minute, geprüft am 14. Oktober 2026
- Penn State IRB Guideline XI, Forschung mit Audio-, Video- oder Digitalaufnahmen: https://researchsupport.psu.edu/orp/irb/irb-resources-training-and-events/irb-guidelines/irb-guideline-xi-research-involving-audio-video-or-digital-recordings-of-research-participants/
- University of Florida IRB, Anforderungen an Forschende zur Aufbewahrung von Forschungsdaten: https://irb.ufl.edu/index/data/investigator-requirements-for-retaining-research-data.html
- Braun und Clarke, Überblick zur reflexiven thematischen Analyse: https://www.maxqda.com/research-guides/thematic-analysis
- Grounded Theory, Methodengeschichte und Codierungsansätze: https://pmc.ncbi.nlm.nih.gov/articles/PMC6318722/
- Das Jefferson-Transkriptionssystem erklärt: https://universitytranscriptions.co.uk/jefferson-transcription-system-a-guide-to-the-symbols/
- REFI-QDA-Format und Interoperabilität von QDA-Software: https://www.quirkos.com/learn-qualitative/refi-qda-exchange-atlasti-nvivo-maxqda.html
- ATLAS.ti, Datenanonymisierung in der qualitativen Forschung: https://atlasti.com/research-hub/data-anonymization-qualitative-research
- Statistics Solutions, Member Checking in der qualitativen Forschung: https://www.statisticssolutions.com/member-checking-in-qualitative-research/
- ConvertAudioToText Sicherheit: Fakten zu Verschlüsselung, Aufbewahrung und Zertifizierung
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Spotify-Podcast-Transkript: Kostenlose Wege zum Abrufen, Kopieren und Herunterladen
Holen Sie sich ein kostenloses Spotify-Podcast-Transkript: Wann das eigene Transkript von Spotify ausreicht, der Weg über YouTube und RSS und wie Sie mit einem Episodenlink Text zum Kopieren und Herunterladen erhalten.
Medizinische Transkription für Behandlungsnotizen: Ein praktischer KI-Workflow für Mediziner
So nutzen Mediziner KI-Transkription für Behandlungsnotizen. Ein praktischer CATT-Workflow für Audio-Upload, Sprechererkennung, Zusammenfassungen und TXT- oder DOCX-Export.