
Transcription d'entretien de recherche : guide qualitatif 2026
Summarize this article with:
Pour transcrire des entretiens de recherche, choisissez votre niveau de verbatim avant d'enregistrer, obtenez un consentement écrit précisant le mode de transcription de l'audio, passez les enregistrements dans un outil d'IA pour obtenir un premier brouillon avec identification des locuteurs, relisez chaque transcription en écoutant l'audio, anonymisez lors d'une passe distincte, puis importez les fichiers TXT ou DOCX dans NVivo, MAXQDA ou ATLAS.ti. Prévoyez 1,5 à 2,5 heures de relecture par heure d'entretien pour une vérification minutieuse, contre 4 à 6 heures pour tout taper à la main. L'analyse thématique fonctionne généralement à partir d'un verbatim épuré ; l'analyse de conversation et du discours nécessite un verbatim intégral.
Pour transcrire un entretien de recherche, choisissez votre niveau de verbatim, enregistrez avec un consentement écrit, obtenez un premier brouillon par IA avec identification des locuteurs, relisez-le en écoutant l'audio, anonymisez-le, puis importez-le dans votre logiciel d'analyse. Taper une heure d'entretien à la main prend 4 à 6 heures. Avec un brouillon IA, une relecture attentive prend environ 1,5 à 2,5 heures. Cette relecture n'est pas du temps perdu : dans la plupart des traditions qualitatives, c'est votre première lecture approfondie des données.
Ce guide couvre l'ensemble du processus pour les entretiens, les focus groups et les cours enregistrés, du consentement à l'importation dans NVivo, avec les décisions sur lesquelles votre jury ou vos évaluateurs vous interrogeront.
Réponse rapide : le processus de transcription d'un entretien de recherche
| Étape | Ce que vous faites | Pourquoi c'est important |
|---|---|---|
| 1. Consentement et préparation | Consentement écrit couvrant l'enregistrement, qui transcrit, le stockage et la conservation | Les comités d'éthique traitent le consentement à l'enregistrement comme une clause à part entière |
| 2. Niveau de verbatim | Verbatim intégral ou verbatim épuré, décidé une fois pour toute l'étude | Changer en cours de projet fausse la comparaison inter-cas |
| 3. Premier brouillon IA | Importation par lots avec identification des locuteurs activée | Quelques minutes par fichier au lieu de plusieurs heures |
| 4. Relecture | Lire la transcription tout en écoutant l'audio | Des mots erronés deviennent des codes erronés |
| 5. Conventions | Étiquettes de locuteurs, marqueurs de pauses et non-verbaux, horodatages | La cohérence permet le codage automatique par locuteur |
| 6. Anonymisation | Remplacer les identifiants lors d'une passe distincte, tenir un registre | Protège les participants et votre approbation éthique |
| 7. Importation et stockage | TXT ou DOCX dans NVivo, MAXQDA ou ATLAS.ti ; stocker selon le protocole | Piste d'audit pour la publication |
Niveaux de verbatim : ce que vous choisissez réellement
Il existe trois niveaux de fidélité de transcription, et les mélanger crée des problèmes par la suite.
Le verbatim intégral (ou true verbatim) capture chaque mot tel qu'il est prononcé : les tics de langage (« euh », « tu vois », « genre »), les faux départs, les phrases répétées et les sons non verbaux comme les rires, les longues pauses et les soupirs. La transcription a l'air brouillonne. C'est aussi le seul format qui permet l'analyse conversationnelle, l'analyse du discours et l'enquête narrative, où la manière dont quelque chose est dit porte l'argumentation.
Le verbatim intelligent (aussi appelé verbatim épuré, nettoyé ou transcription dénaturée) conserve l'intégralité du contenu et du sens, mais supprime les tics de langage, les faux départs et les répétitions redondantes, et lisse légèrement la grammaire. C'est le choix par défaut pour l'analyse thématique, l'analyse de contenu, la théorisation ancrée et la plupart des recherches sur les politiques publiques. C'est ce que la majorité des chercheurs entendent par « transcription ».
La transcription synthétique condense l'entretien en points clés. Elle convient aux études de faisabilité et au repérage préliminaire, mais pas à l'analyse primaire, car elle place l'interprétation du transcripteur avant la vôtre.
Si vous n'êtes pas sûr du niveau requis par votre méthode, choisissez le verbatim intégral. Vous pourrez toujours nettoyer une transcription intégrale plus tard. Vous ne pourrez pas récupérer les hésitations et les pauses à partir d'une transcription nettoyée sans revenir à l'audio.
L'analyse conversationnelle va plus loin et superpose la notation de Jefferson (chronométrage, chevauchement, hauteur de la voix, prosodie) au verbatim intégral. Aucun outil d'IA actuel ne la produit ; utilisez donc l'IA pour une première passe et appliquez la notation à la main.
Normes de précision selon la méthode
| Méthode | Niveau de verbatim | Tolérance de précision | Notes |
|---|---|---|---|
| Analyse conversationnelle | Verbatim intégral + notation de Jefferson | Quasi parfaite | Le brouillon IA n'est qu'un point de départ |
| Analyse du discours | Verbatim intégral | Élevée, relecture humaine requise | La durée des pauses et les chevauchements comptent |
| Enquête narrative | Verbatim intégral | Élevée | La façon dont l'histoire est racontée constitue la donnée |
| Théorisation ancrée | Verbatim épuré | Modérée à élevée | Le codage se fait ligne par ligne, un mot faux donne un code faux |
| Analyse thématique | Verbatim épuré | Modérée | La lisibilité aide à la familiarisation |
| Analyse de contenu | Verbatim épuré | Modérée | Les erreurs modifient les comptages de fréquence |
| Phénoménologie | Verbatim épuré avec segments intégraux | Modérée | Garder exactes les descriptions de l'expérience vécue |
L'analyse thématique réflexive de Braun et Clarke traite la familiarisation comme la première phase de l'analyse, et non comme une simple préparation. Relire une transcription IA en écoutant l'audio constitue ce travail de familiarisation. Pour approfondir ces méthodes, consultez l'analyse thématique à partir de transcriptions, le codage d'entretiens qualitatifs et la transcription pour la théorisation ancrée.
Étape 1 : Consentement et configuration de l'enregistrement
Les participants doivent consentir par écrit à l'enregistrement avant que vous n'appuyiez sur le bouton. Le consentement à l'enregistrement est une autorisation explicite et distincte, pas une ligne noyée dans un accord général de participation à l'étude. Votre formulaire doit préciser :
- Que l'entretien fera l'objet d'un enregistrement audio
- Qui le transcrira : votre équipe, un prestataire ou un outil d'IA
- Où les enregistrements et les transcriptions sont stockés et qui peut les ouvrir
- Combien de temps les enregistrements sont conservés avant suppression
- Si les participants recevront la transcription pour relecture (validation par les participants ou member checking)
Mentionner la transcription assistée par IA dans le formulaire de consentement est la pratique la plus sûre, même si votre établissement ne l'exige pas encore. Envoyez le formulaire par e-mail avant l'entretien afin que les participants puissent le lire et que vous disposiez d'une trace datée.
Pour l'enregistrement, un enregistreur dédié placé près du locuteur surpasse le microphone d'un ordinateur portable, et un téléphone fonctionnant en secours a sauvé de nombreuses études. Testez les niveaux sonores avant de commencer. Enregistrez en WAV, ou en MP3 à 128 kbps ou plus ; l'acoustique de la pièce importe plus que le format de fichier. Nommez immédiatement chaque fichier avec un code participant et une date, par exemple P01_2026-05-15.mp3, afin de le relier aux formulaires de consentement sans exposer l'identité.
Étape 2 : Choisir le niveau de transcription et les conventions
Décidez du niveau de verbatim à partir de la section ci-dessus et rédigez un guide de style d'une page avant de traiter le premier fichier :
- Étiquettes de locuteurs :
Enquêteur :etP03 :, au même format dans chaque transcription - Marqueurs de pause si votre méthode en a besoin :
[pause],[longue pause] - Éléments non verbaux :
[rires],[soupirs],[ému] - Passages inaudibles :
[inaudible 23:45], ou[incertain : « quelque chose à propos du financement »]lorsque vous en entendez une partie. Ne devinez jamais. - Horodatages à chaque prise de parole, ou à intervalles fixes
Si les entretiens 1 à 10 sont en verbatim intégral et les entretiens 11 à 20 en verbatim épuré, votre logiciel d'analyse les traitera comme des documents équivalents alors qu'ils ne le sont pas.
Étape 3 : Générer le premier brouillon par IA
Téléversez l'ensemble du corpus par lots plutôt qu'un fichier à la fois, avec l'identification des locuteurs activée. Ces étiquettes sont essentielles car l'analyse d'entretien dépend du fait de savoir qui a dit quoi. Consultez la diarisation des locuteurs expliquée pour comprendre comment fonctionne l'identification et où elle échoue.
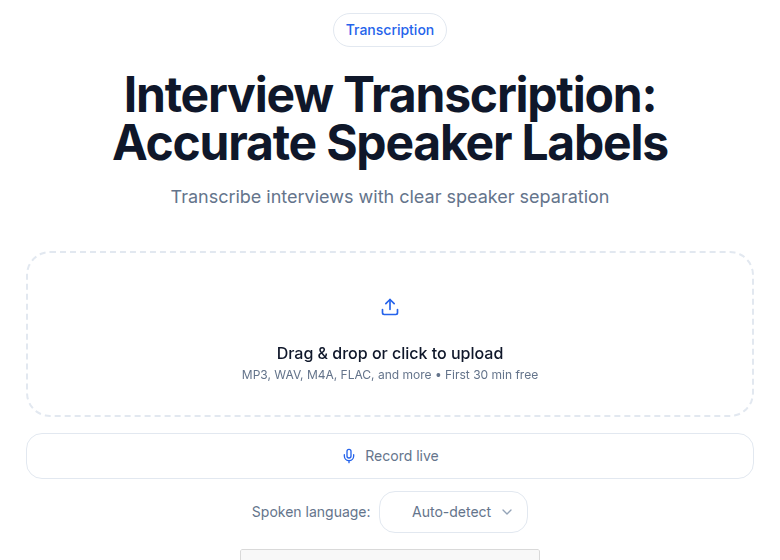 Transcription d'entretien en cours dans ConvertAudioToText
Définissez la langue de l'entretien avant le traitement lorsqu'il ne s'agit pas de l'anglais. La précision chute fortement lorsque la mauvaise langue est sélectionnée. Un entretien de 60 minutes est généralement traité en quelques minutes. La précision est élevée sur un audio clair dans une pièce calme, et plus faible avec des accents, du vocabulaire technique, des chevauchements de parole et des propos chargés d'émotion, que les participants prononcent souvent à voix basse. Consultez la précision de la transcription expliquée pour avoir des attentes réalistes.
Étape 4 : Relire chaque transcription en écoutant l'audio
C'est l'étape que la plupart des chercheurs sous-estiment, et la sauter est l'erreur méthodologique la plus courante dans la recherche qualitative assistée par IA. Écoutez l'audio à une vitesse de 1,0x à 1,25x tout en lisant, et corrigez au fur et à mesure. Concentrez-vous sur :
- Les termes de la discipline ou de la communauté que vos participants utilisent couramment. Constituez d'abord un glossaire et corrigez-les systématiquement.
- Les noms propres : les personnes, organisations, lieux et références culturelles sont souvent devinés phonétiquement.
- Les passages à voix basse ou chargés d'émotion : les plus difficiles à capturer pour l'IA, et souvent ceux qui comptent le plus sur le plan analytique.
- Les chevauchements : vérifiez qui a réellement prononcé chaque réplique, en particulier dans les focus groups.
Une relecture approfondie prend environ 1,5 à 2,5 heures par heure d'audio, contre 4 à 6 heures pour tout taper depuis le début. Pour 20 entretiens, cela permet d'économiser environ 60 à 80 heures. Si plusieurs personnes relisent, demandez à deux d'entre elles de vérifier le même extrait de 15 minutes et de comparer : les différences montrent où vos conventions manquent de précision.
Focus groups, cours magistraux et corpus de thèse
La transcription de focus group est plus difficile que celle d'entretiens individuels car les participants parlent en même temps. Placez le microphone au milieu de la table, demandez à chacun de dire son code participant avant sa première intervention, et renommez les étiquettes de locuteurs une seule fois dans l'éditeur pour que chaque ligne se mette à jour. Prévoyez plus de temps de relecture et vérifiez chaque chevauchement avec l'audio.
La transcription de cours ou séminaires pour la recherche (observation de classe, séminaires enregistrés) nécessite généralement un verbatim épuré et des horodatages plutôt qu'un détail fin des locuteurs. Les longs enregistrements ne posent pas de problème sur les forfaits payants : les liens et les vidéos peuvent durer jusqu'à 24 heures chacun.
La transcription de mémoire ou de thèse représente généralement 20 à 30 entretiens de 45 à 75 minutes, soit 15 à 38 heures d'audio. Traitez l'ensemble du corpus avec les mêmes paramètres et conventions afin que vos données soient homogènes.
Étape 5 : Anonymiser lors d'une passe distincte
La plupart des protocoles exigent une désidentification avant le début de l'analyse. L'histoire orale est la principale exception, où les participants souhaitent souvent être nommés.
L'anonymisation et la pseudonymisation sont différentes. L'anonymisation supprime définitivement les identifiants ; selon le RGPD, des données totalement anonymisées ne sont plus des données personnelles. La pseudonymisation remplace les identifiants par des codes (« P04 » ou « Maya ») tout en conservant une clé de réidentification, de sorte que les données restent soumises à la réglementation. La plupart des études qualitatives pratiquent la pseudonymisation.
Remplacez ou modifiez :
- Les noms complets, y compris ceux des personnes mentionnées par le participant
- Les adresses, les institutions nommées et les lieux identifiables
- Les intitulés de poste suffisamment uniques pour identifier quelqu'un dans son contexte
- Les dates qui réduisent le champ d'identification lorsqu'elles sont combinées à d'autres détails
- Tout ce que le participant a demandé de garder hors enregistrement (off the record)
Tenez un journal d'anonymisation répertoriant ce que vous avez remplacé et par quoi, stocké séparément des transcriptions. Faire cela lors d'une passe dédiée fonctionne mieux que de le faire pendant la relecture, car votre attention porte alors sur le risque d'identification plutôt que sur l'exactitude acoustique. Consultez l'éthique de la transcription d'entretien pour une vue d'ensemble de la conformité.
Étape 6 : Importer dans NVivo, MAXQDA ou ATLAS.ti
Les trois logiciels importent des transcriptions en texte brut et DOCX, et tous trois échangent des projets entiers via le format REFI-QDA (.qdpx) si vous devez changer d'outil en cours de projet. Conservez les noms de fichiers utilisés lors du téléversement et importez-les par lot. Des étiquettes de locuteurs cohérentes vous permettent de coder automatiquement par intervenant. NVivo vend également son propre module de transcription ; le guide NVivo vs transcription IA compare les deux approches.
Étape 7 : Stocker et conserver selon votre protocole
Votre comité d'éthique (ou IRB) attend un plan documenté précisant combien de temps vous conservez les enregistrements, les transcriptions et les formulaires de consentement, et comment chacun est détruit. De nombreux établissements américains fixent un minimum de trois ans après la clôture de l'étude pour les archives de recherche, et les financements publics exigent souvent plus longtemps. Les enregistrements comportent plus de risques que les transcriptions désidentifiées car ils contiennent la voix du participant ; de nombreux comités recommandent donc de les supprimer une fois les transcriptions vérifiées.
- Chiffrez les fichiers au repos et limitez l'accès à l'équipe de recherche.
- Utilisez les serveurs de l'établissement ou un service cloud adapté à la recherche, et non des appareils personnels.
- Conservez les données identifiables séparément des données désidentifiées.
- Consignez le lieu de stockage, la liste d'accès, le calendrier de conservation et la méthode de suppression dans votre dossier d'éthique.
Pour tout fournisseur de transcription par IA, notez dans votre dossier : si l'audio est conservé après le traitement et pendant combien de temps, si le contenu est utilisé pour entraîner des modèles, où les données sont traitées et si un accord de traitement des données (DPA) est disponible.
Pour ConvertAudioToText, voici les éléments factuels à citer : les fichiers sont chiffrés en transit (TLS 1.2 ou plus récent) et au repos (AES-256) ; aucun humain n'examine le contenu des clients ; sur le forfait gratuit, l'audio source est supprimé automatiquement, généralement environ 7 jours après le traitement ; les forfaits payants permettent de choisir la durée de conservation de l'audio (7, 30, 90 ou 180 jours, 1 an, ou sans limite) ; les transcriptions restent dans le compte jusqu'à ce que vous les supprimiez. ConvertAudioToText n'est pas certifié SOC 2, et la signature d'un accord BAA fait l'objet d'une discussion avec l'équipe plutôt que d'une option par défaut. La page sécurité et la liste des sous-traitants donnent tous les détails.
Combien coûte la transcription des entretiens d'une thèse
Prenons 25 entretiens d'environ une heure, soit 25 heures d'audio.
| Option | Coût financier | Votre temps |
|---|---|---|
| Tout taper vous-même | $0 | 100 à 150 heures |
| Service humain chez Rev à 1,99 $ la minute | environ 2 985 $ | Vérifications ponctuelles uniquement |
| Brouillon IA + votre relecture sur ConvertAudioToText Pro | 14,99 $US pour un mois | 38 à 63 heures de relecture |
| Brouillon IA + votre relecture avec le Weekly Pass | 9,99 $US par pass (1 200 minutes, 7 jours), soit deux pass pour 25 heures | 38 à 63 heures de relecture |
Le tarif de transcription humaine de Rev provient de rev.com/pricing, vérifié le 14 octobre 2026.
L'approche hybride est courante : l'IA pour la plupart des entretiens, et un service humain pour les trois ou quatre enregistrements ayant le plus mauvais son ou les enjeux les plus élevés. Une utilisation très intensive sur le forfait Pro, au-delà d'environ 30 heures d'audio sur 30 jours, peut basculer sur le moteur standard. Pour une vue plus large des tarifs, consultez le coût de la transcription par heure.
Contrôles qualité utiles à intégrer
Validation par les participants (member checking). Le cadre de fiabilité de Lincoln et Guba (1985) cite le renvoi des transcriptions aux participants comme une technique de crédibilité. C'est courant en phénoménologie et en théorisation ancrée, moins en analyse conversationnelle.
Piste d'audit (audit trail). Consignez l'outil utilisé, qui a relu chaque transcription, les conventions suivies et chaque arbitrage effectué sur un passage audio peu clair.
Trois erreurs qui se propagent dans toute l'analyse
Traiter la transcription IA comme la source de référence. C'est l'enregistrement audio qui fait foi. Un mot erroné dans une citation devient un code, puis un thème.
Des conventions incohérentes au sein du projet. Décidez-en avant le premier fichier et appliquez-les à chaque transcription.
Sauter l'étape d'anonymisation. Des transcriptions contenant de vrais noms dans un espace de stockage partagé, envoyées à des directeurs de recherche ou archivées sans expurgation peuvent violer les accords de consentement et, le cas échéant, le RGPD ou votre protocole d'éthique.
Par où commencer
Vous pouvez transcrire gratuitement les 30 premières minutes d'un entretien sans créer de compte pour voir ce que donnent vos propres enregistrements. Un compte gratuit permet de transcrire jusqu'à 30 fichiers par jour, de 30 minutes maximum chacun et téléchargements TXT, et votre tout premier fichier peut durer jusqu'à une heure avec export DOCX inclus. Pour des entretiens complets et tous les formats d'exportation, le Weekly Pass ou le forfait Pro couvrent un corpus entier. Les chercheurs peuvent également consulter la page dédiée au monde académique.
FAQ
Quelle est la meilleure façon de transcrire un entretien de recherche ?
Générez un premier brouillon par IA avec identification des locuteurs, puis relisez-le en écoutant l'audio avant de coder quoi que ce soit. Décidez d'abord du niveau de verbatim, utilisez les mêmes conventions dans chaque transcription et anonymisez lors d'une passe distincte. Une transcription IA non relue est un brouillon, pas une donnée.
Qu'est-ce que la transcription en verbatim épuré (ou intelligent) ?
Le verbatim intelligent, aussi appelé verbatim épuré ou nettoyé, conserve tout ce que le locuteur a dit et voulu dire mais supprime les tics de langage (euh, ben, tu vois), les faux départs et les répétitions, et corrige légèrement la grammaire pour la lisibilité. C'est le choix habituel pour l'analyse thématique, l'analyse de contenu et la théorisation ancrée. Le verbatim intégral conserve chaque hésitation, pause et chevauchement, et est nécessaire pour l'analyse conversationnelle et l'analyse du discours.
Puis-je utiliser la transcription par IA pour la recherche qualitative ?
Oui, avec une étape de relecture obligatoire. L'IA produit un brouillon exploitable d'un entretien de 60 minutes en quelques minutes. La précision est élevée sur un audio clair et baisse avec les chevauchements de parole, les accents, le bruit de fond et une voix basse ou chargée d'émotion. Chaque citation que vous publiez doit être vérifiée avec l'enregistrement.
Combien de temps faut-il pour transcrire un entretien d'une heure ?
Le taper vous-même prend généralement 4 à 6 heures. Avec un premier brouillon généré par IA, une relecture attentive avec l'audio prend environ 1,5 à 2,5 heures par heure d'audio, moins sur des enregistrements propres.
Comment transcrire un focus group ?
Enregistrez avec un microphone au centre de la table, demandez aux participants de dire leur nom ou leur code avant de parler au début, et laissez l'identification des locuteurs séparer les voix. Prévoyez plus de temps de relecture que pour un entretien individuel, car les gens parlent en même temps. Renommez les étiquettes de locuteurs avec les codes des participants une seule fois, puis vérifiez chaque chevauchement avec l'audio.
Comment mentionner la transcription par IA dans ma section méthodologie ?
Indiquez que les transcriptions initiales ont été générées avec un logiciel de transcription par IA et que l'équipe de recherche a relu et corrigé chaque transcription en écoutant l'audio original. Certaines revues et comités d'éthique demandent désormais comment les outils d'IA ont traité les données des participants ; suivez donc les directives actuelles de votre établissement et nommez l'outil si cela est demandé.
Dois-je anonymiser les transcriptions avant l'analyse ?
Généralement oui. Remplacez les noms, lieux, employeurs, dates et détails uniques susceptibles d'identifier un participant, lors d'une passe documentée distincte. Conservez la table de correspondance qui lie les pseudonymes aux identités réelles séparément des transcriptions, avec un accès restreint.
Quel logiciel d'analyse qualitative (CAQDAS) fonctionne avec les transcriptions IA ?
NVivo, MAXQDA et ATLAS.ti importent tous des transcriptions en texte brut et DOCX, et échangent des projets entiers via le format REFI-QDA (.qdpx). Choisissez celui dont votre établissement possède la licence et qui correspond à votre méthode.
Combien de temps dois-je conserver les enregistrements et les transcriptions d'entretiens ?
De nombreux établissements américains fixent un minimum de trois ans après la clôture de l'étude pour les archives de recherche, et les financeurs exigent souvent plus longtemps. Les enregistrements comportent plus de risques que les transcriptions désidentifiées ; de nombreux comités d'éthique recommandent donc de les supprimer une fois les transcriptions vérifiées. Votre protocole d'éthique, les conditions du financeur et la politique de votre établissement en décident.
Sources
- Tarifs Rev : transcription humaine à $1.99 par minute, vérifié le 14 octobre 2026
- Penn State IRB Guideline XI, recherches impliquant des enregistrements audio, vidéo ou numériques : https://researchsupport.psu.edu/orp/irb/irb-resources-training-and-events/irb-guidelines/irb-guideline-xi-research-involving-audio-video-or-digital-recordings-of-research-participants/
- University of Florida IRB, exigences relatives à la conservation des données de recherche par les chercheurs : https://irb.ufl.edu/index/data/investigator-requirements-for-retaining-research-data.html
- Présentation de l'analyse thématique réflexive de Braun et Clarke : https://www.maxqda.com/research-guides/thematic-analysis
- Filiation des méthodes de théorisation ancrée et approches de codage : https://pmc.ncbi.nlm.nih.gov/articles/PMC6318722/
- Le système de transcription de Jefferson expliqué : https://universitytranscriptions.co.uk/jefferson-transcription-system-a-guide-to-the-symbols/
- Format REFI-QDA et interopérabilité des logiciels d'analyse qualitative : https://www.quirkos.com/learn-qualitative/refi-qda-exchange-atlasti-nvivo-maxqda.html
- ATLAS.ti, l'anonymisation des données dans la recherche qualitative : https://atlasti.com/research-hub/data-anonymization-qualitative-research
- Statistics Solutions, la validation par les participants (member checking) dans la recherche qualitative : https://www.statisticssolutions.com/member-checking-in-qualitative-research/
- Sécurité ConvertAudioToText : informations sur le chiffrement, la conservation et les certifications
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Transcription d'entretiens pour la recherche médicale : un guide pratique (2026)
Comment les chercheurs en médecine gèrent les informations de santé protégées (PHI), la désidentification, les attentes des comités d'éthique (IRB) et le choix des outils pour la transcription d'entretiens cliniques. Des conseils de conformité honnêtes pour 2026.
Les meilleurs outils de transcription pour articles de recherche et entretiens en 2026
Les chercheurs en milieu académique ont besoin d'une transcription qui gère les longs entretiens, le vocabulaire spécialisé et les interventions multiples avec une précision digne d'une citation. Voici les huit outils qui tiennent la route.
Comment transcrire un entretien de recherche avec des étiquettes de locuteurs
Découvrez un flux de travail pratique pour transformer l'audio d'un entretien de recherche en transcription étiquetée : téléchargez votre fichier, vérifiez les étiquettes de locuteurs et exportez en TXT, SRT ou VTT.
Transcription des entretiens de thèse : le plan doctoral
Comment transcrire 30 à 80 entretiens de thèse doctorale : conformité IRB, décisions spécifiques à la méthode, calcul budgétaire réaliste et un flux de travail que votre jury acceptera.