インタビュー音声の文字起こし方法(2026年版)
Summarize this article with:
1時間のインタビューを手作業で文字起こしすると約4〜6時間かかります。AI文字起こしなら数分で下書きができ、引用前に15〜30分かけて固有名詞、数字、話者ラベルを編集します。ツール間の精度の差は、ソフトウェアではなくマイクと同意確認の設定でほぼ決まります。ジャーナリズムにはケバ取りを選び、元の音声を保管し、公開前にすべての引用を録音と照合してください。
TL;DR. 1時間のインタビューの文字起こしは、手作業で4〜6時間かかりますが、AIなら約5分の処理と15〜30分の編集で終わります。最終的な精度の大部分は、録音ボタンを押す前のマイク選び、部屋、同意確認で決まります。ジャーナリズムにはケバ取りを選び、音声を文字起こしツールにかけ、短い編集作業で固有名詞と数字を修正し、公開前にすべての直接引用を録音と照合してください。元の音声は保管しておきます。
一般的なインタビューでは30〜60分の音声が生成され、それを正確な引用、テーマ、分析に変える必要があります。文字起こしはその土台です。正しく行えば執筆はスムーズに進みます。間違えれば、録音から誤引用の言葉を探すのに何時間も失うか、最悪の場合は存在しない引用を公開して訂正記事を出すことになります。
私はConvertAudioToTextを開発しているため、一日中文字起こしを読んで編集しています。以下のワークフローは、締め切りに追われるジャーナリストや定性研究者にとって実用的なものです。インタビュー前に行う設定の判断は、ソフトウェアよりもはるかに大きく精度を左右します。特にジャーナリストの方は、報道機関のワークフロー全体を網羅したジャーナリスト向け文字起こしツールのページも確認してください。
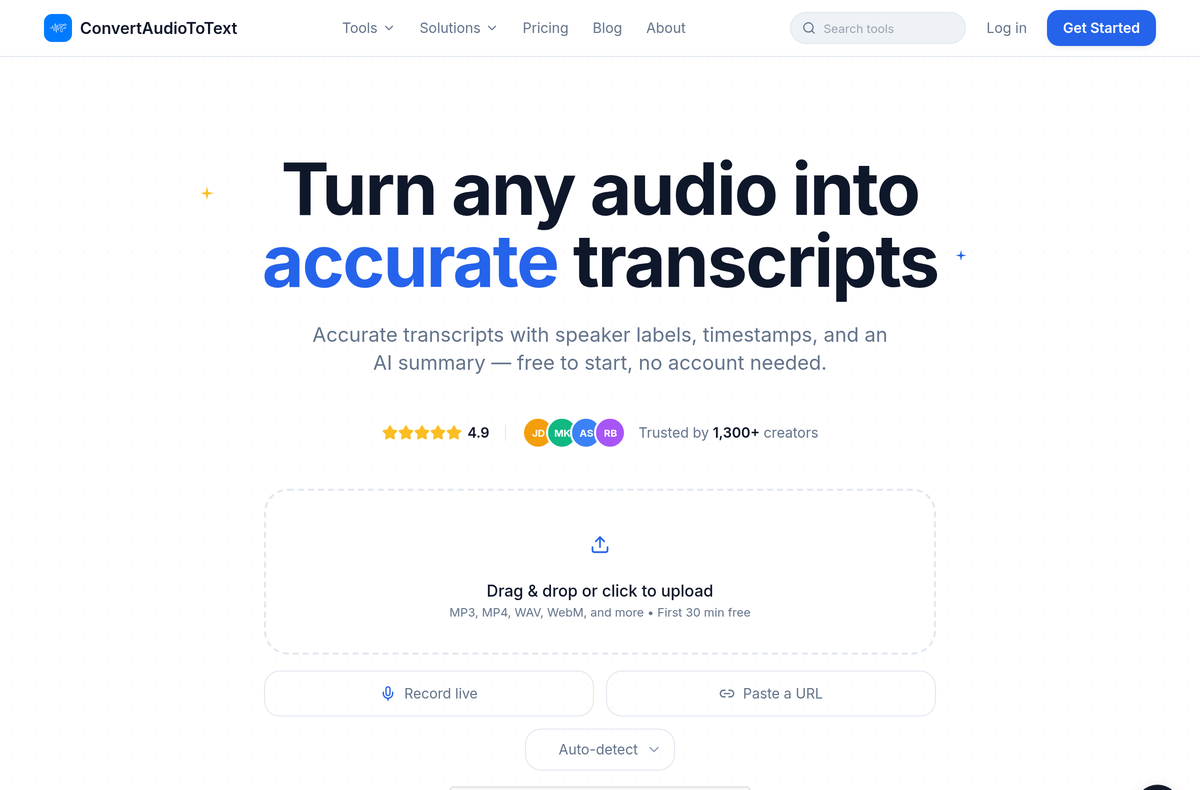 ConvertAudioToTextへのインタビュー録音のアップロード:ファイルのドラッグ&ドロップ、ライブ録音、またはURLの貼り付け。アカウント不要で最初の30分は無料。
AIが実際に節約できる時間
手作業の文字起こしにはよく知られた比率があります。経験豊富な文字起こし作業者でも1時間の音声に対して約4時間のタイピングを要し、音質が悪い場合や複数話者の場合はその2〜3倍になります(GMR Transcription)。人間の脳は毎分125〜175語のペースで発話を理解しますが、ほとんどの人のタイピング速度は毎分60〜90語なので、絶えず一時停止と巻き戻しを繰り返すことになります。
AIはこの計算を覆します。60分のインタビューは約3〜5分で文字起こしされ、節約できた時間を人間が必要な作業、つまり編集と取材に充てられます。
| 方法 | 1時間のインタビューにかかる時間 | 費用 | 最適な用途 |
|---|---|---|---|
| 手作業 | 4〜6時間 | 自分の時間 | 短いクリップ、法廷レベルの素起こし、最大限の管理 |
| AI下書き+自分で編集 | 5分の処理+15〜30分の編集 | 無料〜数ドル | ほとんどのインタビュー |
| 人間の文字起こしサービス | 納期12時間〜数日 | 音声1分あたり約$1.50〜$2 | 強い訛り、法廷レベルの精度、予算がある場合 |
ほぼすべてのインタビューで、損益分岐点は明らかです。 手作業が勝るのは、録音がひどく乱れていてAIの下書きを修正するより最初から入力した方が早い場合だけですが、それは通常、元の音質が悪かったことを意味します。それは録音の問題であり、まずは録音から見ていきましょう。
録音前:精度を決めるパート
最もクリーンな文字起こしは最もクリーンな音声から生まれます。そしてクリーンな音声は録音時の設定で決まるもので、事後の編集で直せるものではありません。マイクが拾えなかった言葉を復元できるモデルは存在しません。
形式にマイクを合わせる
- 対面。 ピンマイクを2つ、または自分と取材対象者の間にショットガンマイクを1つ配置します。Zoom Hシリーズのようなフィールドレコーダーなら各話者を別々のトラックに録音できるため、話者ラベルの信頼性が大幅に上がります。
- リモートビデオ通話。 可能な限り各話者をローカルで録音します(RiversideやZencastrなどが対応)。これにより、圧縮された通話品質の1つのストリームではなく、全員の声が独自のクリーンなファイルになります。
- 電話。 60センチ離れた室内マイクでスピーカーフォンを拾うのではなく、通話録音アプリか専用のレコーダーを使います。
避けるべきこと:机の向こうにあるノートPCの内蔵マイクや、テーブル上の1台のスマートフォンに2人で身を乗り出すこと。どちらも中程度の音質になり、AIモデルは文字起こし自体は行うもののエラーが増え、後から耳で聞いて探し出す羽目になります。機材の詳細については、ジャーナリストに最適なレコーダーおよび録音の背景ノイズへの対処法を参照してください。
記録に残る形で同意を得る
録音に関する法律は法域によって異なり、非常に重要です。米国の一部の州では全員の同意(録音前に全員が同意すること)が義務付けられており、カリフォルニア、フロリダ、イリノイ、ペンシルベニアは最も厳しい州に含まれます。いくつかの州は法解釈が分かれているか複合的(ネバダとミシガンは裁判所によって解釈が異なる)なので、この段落を含め、ネットで見つけた単純なリストを鵜呑みにしないでください。各州の詳細は州別の合法的なインタビュー録音およびJustiaの50州調査で確認してください。
一方当事者の同意で足りる州であっても、同意を録音しておくことは良い習慣であり、後でインタビュー内容が争われた場合に身を守れます。標準的な切り出し方は「正確を期すために録音していますが、よろしいですか?」です。口頭での「はい」を待ちます。この記録された一言が文字起こしに入り、文書化された許可になります。
最初に文字起こしスタイルを選ぶ
インタビューの前に、文字起こしをどの程度忠実にするかを決めます。この選択によって編集方法や引用の仕方が変わります。
- 素起こし(ストリクト・バーベイタム) は、「えー」や言い直し、間をすべて残します。法的証拠、音声分析、一部の定性研究で必要です。
- インテリジェント・バーベイタム は、フィラーや言い直しを省き、文法は話された通りに保ちます。学術研究の標準です。
- ケバ取り(クリーン・バーベイタム) は、フィラーを省き、言い直しを軽く整えます。ジャーナリズムの標準です。
- 整文(エディテッド) は、きれいな散文に書き直します。これは最終的な公開引用にのみ使い、保存用の文字起こしには絶対に使わないでください。
ジャーナリズムでは、ほぼ常にケバ取りが正解です。 紙面で誰をも悪く見せてしまうノイズを取り除きつつ、話者のトーンをそのまま保てるからです。それぞれのトレードオフは素起こしとケバ取りの比較で解説しています。
インタビュー中:後で役立つ3つの習慣
- 相手が話し終わるのを待つ。 声の重なり(クロストーク)は文字起こしエラーの最大の原因です。重なって話す2人をきれいに分離できるモデルや話者分離ツールは存在しないからです。室内では長く感じる0.5秒の間も、テキスト上ではきれいに読めます。
- 珍しい名前や専門用語を復唱する。 「確認ですが、スペルはC-O-O-L-I-F-Yですね?」と聞くことで、文字起こしに明確な基準ができ、後の事実確認の手間が省けます。
- 際立った発言のタイムスタンプをメモする。 ノートに「23:17、ミッションステートメント」と書いておけば、後で引用を探す作業が10秒のシークで終わります。
文字起こしの手順
1. トリミングと変換
最初と最後の無音部分をカットします。ファイルが動画(ZoomやRiversideのMP4)の場合、音声のみで問題なく、アップロードも速くなります。
ffmpeg -i interview.mp4 -vn -acodec mp3 -ab 192k interview.mp3
これで発話の精度を実質的に損なうことなく、ファイルサイズを約80%削減できます。
2. アップロードと設定
ファイルを文字起こしツールにドロップします。無料の英語文字起こしツールならアカウント不要で短いインタビューを処理でき、生のテキストの塊ではなく構造化された出力(抜粋引用、事実確認すべき主張、リード文の候補)が必要な場合は、ジャーナリズムインタビューテンプレートが最適な入り口になります。
精度を左右する3つの設定:
- 言語。 特に英語以外の音声では、自動検出に頼らず言語を指定します。
- 話者数。 実際の人数を設定します(1対1なら2、記者1人と対象者2人なら3)。話者分離は、見つけるべき声の数を推測させない方が正確になります。
- 語彙またはキーワードブースト。 珍しい名前、専門用語、固有名詞を渡します。5単語のリストを渡すだけで、初回処理で毎回発生するブランド名や姓の誤りを防げます。
3. 実行
60分のインタビューは通常3〜5分で処理され、処理時間は音声の長さにほぼ比例します。最新のAI文字起こしは**実際の会話音声で単語誤り率(WER)約8〜12%**となり、クリアな録音ではより良く、ノイズの多い通話品質では悪化します(Whisper WERベンチマーク)。だからこそ編集作業が存在し、マイク設定が重要になります。クリアな録音ならその範囲の良好な方に収まります。
4. 15分間の編集作業
これは最も重要でありながら、多くの人が省いてしまうステップです。音声と同期した状態で文字起こしを開きます(CATTのエディターはテキストと音声をリンクするため、任意の単語をクリックしてその位置にシークできます)。
- 1.5倍速で再生し、聞きながらテキストにざっと目を通します。
- 問題になりそうな箇所で一時停止して修正します。
- 固有名詞。 初回処理ではほぼ常に間違っています。
- 数字。 金額や日付の誤りはそのまま公開されやすく、恥をかくことになります。
- 話者ラベル。 最初の1分間が正しいか確認すれば、残りは通常それに続きます。
- 意味が変わる誤り。 「ない」の脱落や、同音異義語の誤変換など。
- 文体の好み、フィラーの議論(ケバ取りを選んだ場合)、細かい句読点は飛ばします。
60分のインタビューなら編集に15〜30分かかるはずです。それ以上かかる場合は、元の音質が悪く、編集ではなく書き直しをしています。精度のギャップを埋める詳細は文字起こしの精度が変動する理由をご覧ください。
引用の抽出と確認
文字起こしができました。次は引用が必要であり、それが実際に語られた通りの言葉である必要があります。
引用を見つける
- 検索と流し読み(切り口がすでに決まっている短い記事向け):キーワードを検索し、該当箇所を抜き出します。
- ハイライト作業(長文記事向け):文字起こし全体を一度読み、引用できそうな箇所をすべてマークしてから、テーマごとに最も強い3〜5個を選びます。
- 構造化出力(作業を効率化したい場合):ジャーナリズムインタビューテンプレートはテーマ、引用候補、リード文の提案を返します。これを下書きとして扱い、すべて音声と照合してください。完全な手法はインタビューから引用を抽出する方法にあります。
公開前に確認する
直接引用を記事に出す前に:
- 文字起こしの中で引用箇所を見つけます。
- クリックして音声のその瞬間にシークします。
- 前後の文脈を聞きます。
- 強調やトーンを含め、言い回しを確認します。
クリックしてシークできるエディターなら、引用1つにつき約30秒です。これを省くことは、他のどのワークフローの抜け漏れよりも多くの訂正記事を生んでいます。 AIは一見もっともらしい形で微妙に言葉を間違えるため、読み返しでは気づけないミスも、少し耳で聞くだけで見つけられます。
正直な比較:ツールの実際の違い
ツールは録音環境ほど重要ではありませんが、料金は当然気になる点です。インタビューや研究に特化したツールは、どの程度自動で編集してくれるか、人間レベルのオプションがあるか、そして料金体系の3つのトレードオフに集約されます。
| ツール | モデル | 無料枠 | 有料プランの入り口 | インタビュー向けの特記事項 |
|---|---|---|---|---|
| ConvertAudioToText | AI、月額定額 | アカウント不要で全ファイルの最初の30分。無料アカウント:最初のファイルはプレミアム、以降1日最大30ファイル(各最大30分)はスタンダード | 月額$14.99または年額$99.99から。1,200分使える買い切りのWeekly Passは$9.99 | 話者ラベル、クリックでシークできるエディター、構造化されたジャーナリズム/研究テンプレート、アフリカ諸語+非英語のカバー率 |
| Otter.ai | AI、リアルタイム | 月300分(Basic) | Pro 月額$8.33/ユーザー(年払い) | ライブ会議の録音とメモ(otter.ai/pricing) |
| Descript | AI、編集優先 | 月1時間 | Hobbyist 月額$16(10時間) | 文字起こしを編集して音声/動画を編集(descript.com/pricing) |
| Trint | AI、報道機関向け | なし | Starter 月額約$52 | 編集チーム向けの共同作業と翻訳 |
| Rev | AI+人間 | AI月45分 | Essentials 月額$29.99。人間は音声1分あたり約$1.50〜$2 | 99%の精度が絶対条件の場合の人間による文字起こし(rev.com/pricing) |
一言で言うと: ほとんどのインタビューでは、優秀なAIツールと丁寧な編集作業の組み合わせが有料の人間の文字起こしに勝ります。Revの分単価の人間レートを払う唯一の理由は、法廷、強い訛り、または法的リスクにより、最後の数パーセントの精度に約20倍のコストを払う価値がある場合だけです。人間による追加料金がいつ価値を持つかの完全な内訳は、AIと人間の文字起こしの比較を参照してください。上記の価格は2026年半ば時点のもので変動するため、契約前に各ベンダーのページを確認してください。
複数話者およびパネルインタビュー
3人以上の対象者がいるパネル形式のインタビューは難易度が高く、それを率直に認識しておくことで誤ったラベルを信じるのを防げます。
- ある程度の誤割り当てを想定する。 実際に使用するすべての引用で話者ラベルを確認してください。
- 声の重なりが悪化する。 1つのマイクからの音声の一部が聞き取れなくなります。環境を管理できるなら、話者ごとのマイクで大部分は解決します。
裏側のラベル付けの仕組みについては、話者分離(ダイアライゼーション)の解説で取り上げています。
英語以外のインタビューと翻訳
インタビューがスペイン語、フランス語、ポルトガル語、アラビア語、またはその他の言語である場合は、まず元の言語で文字起こししてください。文字起こしと同時に翻訳させるよりも出力が正確になり、引用元となる忠実な記録が手元に残ります。
その後、別のステップとして文字起こしを翻訳します(重要度に応じてDeepL、Google翻訳、または人間の翻訳者を使用)。重要な箇所は原語で引用し、英語で公開する場合は翻訳して載せます。CATTは、完成した文字起こしをウォロフ語、スワヒリ語、ハウサ語など、多くの既存ツールが全く提供していない言語に翻訳することもできます。
機密性の高い内容の扱い
インタビュー内容によっては慎重な扱いが必要です。
- オフレコの発言。 文字起こし内でマークを付けます(「オフレコ開始」/「オフレコ終了」)。後で実際に何が言われたかを確認する必要が生じるかもしれないため、アーカイブからは削除しないでください。ただし、そこから引用はしません。
- 背景説明(バックグラウンド)の発言。 同じ扱いで、文脈の理解には使えますが情報源の明示(帰属)はできません。
- 匿名の情報源。 文字起こしを編集者に渡す前に、名前を仮名に置き換えます。対応表のある原本は別にして安全に保管してください。
- 立場が弱い取材対象者。 被害者、未成年者、内部告発者など。録音自体を機密として扱い、アクセスできる人を制限します。
研究インタビューテンプレートと記者会見テンプレートは、その他の取材状況に応じた構造化出力に対応しています。
音声、文字起こし、メモを一緒に保管する
1つのインタビューに関するすべてのデータを、一貫した名前の1つのフォルダにまとめます。
2026-05-26_alice-jones-interview/
  ├── audio.mp3
  ├── transcript.txt
  ├── transcript.docx
  ├── consent-line-timestamp.txt
  ├── notes-during-interview.md
  └── pull-quotes.md
長期にわたる調査の場合は、プロジェクトごとに階層化します(project-alpha/2026-05-26_alice/...)。文字起こしは検索可能なデータベースになり、半年後でも1分以内に任意のインタビューを見つけられます。元の音声は絶対に捨てないでください。 ストレージは安価であり、万が一引用に異議を唱えられた場合に自分の正当性を証明できるのは録音だけです。
記者の時間を最も奪う3つのミス
- 習慣で手作業の文字起こしをする。 4〜6時間のタイピングが、5分の処理と短い編集に置き換わります。浮いた時間は取材と執筆に回せます。
- 編集作業を省く。 生のAI文字起こしから直接引用を公開するのは、存在しない引用が記事になる原因です。引用する前に必ず編集してください。
- 音声を保管しない。 録音がなければ、異議を唱えられた引用を確認できません。そしてそれこそが、録音を最も必要とする状況です。
次のインタビューで試すこと
ドライブにインタビューの音声が眠っているなら、無料の英語文字起こしツールにかけ、次にジャーナリズムインタビューテンプレートに通して、その構造化出力と自分で読んでまとめた場合の結果を比較してみてください。ほとんどのインタビューでは、最初にざっと読んだだけでは見落としていたはずの強力な引用が、テンプレートの出力に少なくとも1つは含まれています。これこそ、タイピングは機械に任せて自分は取材に集中すべき理由です。
よくある質問
1時間のインタビューを文字起こしするのにどのくらい時間がかかりますか?
手作業ではクリアな音声で4〜6時間かかり、録音が悪いか複数話者の場合はその2〜3倍になります。AIなら下書きの生成に約3〜5分、引用前の編集に15〜30分です。
AIによるインタビュー文字起こしの精度はどのくらいですか?
最新のAIは実際の会話音声で単語誤り率(WER)約8〜12%で、クリアな録音ではより良く、ノイズや強い訛りがあると悪化します。作業用の下書きには十分ですが、未編集の直接引用には使えないため、編集と引用確認が必要です。
AIと人間の文字起こしサービスのどちらを使うべきですか?
ほぼすべてのインタビューでAIを使ってください。クリアな録音と短い編集作業で、無料または数ドルで公開可能な引用が得られます。人間の文字起こし(音声1分あたり約1.50〜2ドル)にお金を払うのは、音声が非常に聞き取りにくい場合や、宣誓供述書や法廷記録など法的な精度が求められる場合のみです。
ジャーナリズムにはどの文字起こしスタイルを選ぶべきですか?
ケバ取り(クリーン・バーベイタム)です。フィラーを省き、言い直しを軽く整えつつ、話者の実際の言葉とトーンを保ちます。素起こし(ストリクト・バーベイタム)は法的証拠や音声分析にのみ使い、完全に編集された文章は最終的な公開引用のみに留め、保存用の記録には使わないでください。
インタビューを録音することは合法ですか?
法域によって異なります。米国の一部の州では会話の全員の同意が必要で、いくつかの州では法解釈が分かれています。冒頭で記録に残る口頭同意を録音しておけば、どこでも身を守れます。録音前に州別ガイドとJustiaの50州調査で詳細を確認してください。
外国語のインタビューはどのように文字起こししますか?
まず元の言語で文字起こしし、別のステップとしてテキストを翻訳します。文字起こしと同時の翻訳は精度が落ち、引用に必要な忠実な記録が失われます。ConvertAudioToTextは自動検出で99言語を文字起こしでき、スペイン語、フランス語、アラビア語、ヒンディー語など話されている言語を自分で選択することもできます。
誰が何を言ったかが誤って割り当てられるのはなぜですか?
話者分離(ダイアライゼーション)は、声の重なりや似た2つの声に弱く、3人以上のパネルではさらに精度が落ちます。各話者を別々のマイクで録音すると改善します。公開する引用の話者ラベルは必ず確認してください。
別の音声ファイルを用意せずにZoomや動画のインタビューを文字起こしできますか?
はい。MP4を直接アップロードするか、FFmpegで先に音声のみを抽出してファイルを小さくし、アップロードを高速化できます。音声のみにしても文字起こしの精度は一切落ちません。
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Spotify Podcast Transcript: Free Ways to Get, Copy and Download the Text
Get a Spotify podcast transcript free: when Spotify's own transcript is enough, the YouTube and RSS routes, and how to paste an episode link for text you can copy and download.
Medical Transcription for Clinical Notes: A Practical AI Workflow for Clinicians
Learn how clinicians use AI transcription for clinical notes. A practical CATT workflow for audio upload, speaker labels, summaries, and TXT or DOCX export.