
研究インタビューの文字起こし:質的研究のための2026年版ガイド
Summarize this article with:
研究インタビューの文字起こしでは、録音前に逐語レベルを決め、音声の文字起こし方法を明記した書面での同意を取得し、話者ラベル付きのAIツールで初稿を作成し、音声を聴きながら全文を確認し、別工程で匿名化を行ってからTXTまたはDOCXファイルをNVivo、MAXQDA、ATLAS.tiにインポートします。手作業でゼロから入力すると1時間の音声あたり4〜6時間かかりますが、AI下書きの精緻な確認なら1.5〜2.5時間で済みます。主題分析には通常ケバ取り(intelligent verbatim)が適しており、会話分析や談話分析には素起こし(true verbatim)が必要です。
研究インタビューを文字起こしする際は、逐語レベルを決定し、書面で同意を取得して録音し、話者ラベル付きのAI初稿を作成し、音声と照合して確認し、匿名化を行ってから分析ソフトウェアにインポートします。 1時間のインタビューを手作業で文字起こしすると4〜6時間かかります。AIの下書きを活用すれば、入念な確認作業は約1.5〜2.5時間で完了します。この確認作業は無駄な時間ではありません。大半の質的研究において、データと深く向き合う最初の精読プロセスとなります。
本ガイドでは、インタビュー、フォーカスグループ、講義録音を対象に、同意取得からNVivoへのインポートまでの一連の流れと、審査委員会や査読者から問われる判断基準について解説します。
概要:研究インタビュー文字起こしのワークフロー
| 段階 | 作業内容 | 重要である理由 |
|---|---|---|
| 1. 同意取得と録音準備 | 録音、文字起こしの実施者、保管場所、保存期間を網羅した書面同意 | 倫理審査では録音の同意は個別開示事項として扱われます |
| 2. 逐語レベルの決定 | 素起こしかケバ取りかを研究全体で統一 | 途中で変更するとケース間の比較妥当性が崩れます |
| 3. AIによる初稿作成 | 話者ラベルを有効にしてバッチでアップロード | 数時間かかる作業がファイルあたり数分に短縮されます |
| 4. 音声との照合確認 | 音声を再生しながらテキストを精読 | 単語の誤認識は誤ったコーディングに直結します |
| 5. 記述ルールの適用 | 話者ラベル、沈黙や非言語情報の表記、タイムスタンプ | 表記の統一により話者ごとの自動コーディングが可能になります |
| 6. 匿名化処理 | 識別情報を別工程で置換し、変更履歴を記録 | 参加者のプライバシーと研究倫理承認を守ります |
| 7. インポートと保管 | TXTまたはDOCXをNVivo、MAXQDA、ATLAS.tiへ取り込み、規定に沿って保管 | 論文公開に向けた監査証跡となります |
逐語レベルの選択基準
文字起こしの忠実度には3つのレベルがあり、これらを混同すると後の分析で支障をきたします。
素起こし(True verbatim)は、発話されたすべての単語をそのまま記録します。フィラー(「えーと」「あの」「なんか」)、言い淀み、言い直し、笑い声、長い沈黙、ため息などの非言語音も含みます。テキストの見た目は乱雑になりますが、どのように語られたかが論拠となる会話分析、談話分析、ナラティブ探究に対応できる唯一の形式です。
ケバ取り(Intelligent verbatim / クリーンバーバティム)は、発言の内容と意味を完全に維持しながら、フィラー、言い淀み、無駄な繰り返しを削除し、文法を軽く整えて読みやすくします。これは主題分析、内容分析、グラウンデッド・セオリー、多くの政策研究における標準的な選択肢です。一般に研究者が「文字起こし」と言う場合、この形式を指します。
要約起こし(Summary transcription)は、インタビューの要点のみを簡潔にまとめます。予備調査や初期のマッピングには適していますが、作業者の主観的解釈が研究者自身の分析よりも先に入り込んでしまうため、本格的な質的分析には適していません。
採用する手法にどのレベルが必要か判断に迷う場合は、素起こしを選択してください。素起こしの原稿から後でケバ取りを行うことは容易ですが、一度ケバ取りされた原稿から音声に戻ることなくフィラーや沈黙を復元することはできません。
会話分析ではさらに進んで、素起こしの上にジェファーソン方式の表記法(タイミング、重なり、ピッチ、韻律)を重ねます。現行のAIツールでこれを直接出力できるものはないため、AIで初稿を作成した上で手作業で記号を付与します。
研究手法別の精度基準
| 手法 | 逐語レベル | 許容誤差 | 留意点 |
|---|---|---|---|
| 会話分析 | 素起こし + ジェファーソン表記 | ほぼゼロ | AI下書きは初期の土台としてのみ使用 |
| 談話分析 | 素起こし | 極めて高精度、人間による確認必須 | 沈黙の長さや発話の重なりが重要 |
| ナラティブ探究 | 素起こし | 高精度 | どのように物語られたか自体がデータ |
| グラウンデッド・セオリー | ケバ取り | 中〜高精度 | 1行ずつコードを付与するため、単語の誤りが誤コードにつながる |
| 主題分析 | ケバ取り | 中程度 | 読みやすさがデータの熟知を促進 |
| 内容分析 | ケバ取り | 中程度 | 語句の誤認識が出現頻度の集計を狂わせる |
| 現象学 | ケバ取り(体験の記述部分は素起こし) | 中程度 | 生きられた経験の生々しい記述は正確に残す |
BraunとClarkeの反省的主題分析(Reflexive Thematic Analysis)では、データへの熟知(familiarization)を分析の前準備ではなく分析の「第1フェーズ」と位置づけています。AI文字起こしを音声と照合して確認する作業こそが、まさにその熟知作業にあたります。詳細な手法については、文字起こしからの主題分析、質的インタビューのコーディング、グラウンデッド・セオリーのための文字起こしを参照してください。
フェーズ1:同意取得と録音環境の準備
録音ボタンを押す前に、参加者から録音に関する書面での同意を得る必要があります。 録音の同意は研究全体の同意書の中に1行紛れ込ませるのではなく、明確に独立した説明事項として扱わなければなりません。同意書には以下を記載します。
- インタビューが音声録音されること
- 文字起こしを誰が行うか(研究チーム、外部業者、またはAIツール)
- 録音データと文字起こしテキストの保管場所およびアクセス権者
- 削除までの録音データの保存期間
- 参加者が文字起こしを確認する機会(メンバーチェッキング)があるかどうか
所属機関でまだ義務付けられていない場合でも、同意書にAI支援による文字起こしを行う旨を明記しておく方が安全です。インタビュー前にメールで同意書を送付し、事前に目を通してもらった上で日付入りの記録を残しておきます。
録音機器については、話者の近くに置いた専用レコーダーの方がノートPCの内蔵マイクよりもはるかに優れており、スマートフォンを予備として同時に回しておくことで多くの研究がデータ消失の危機を免れています。開始前に必ず音量レベルをテストしてください。録音形式はWAV、または128 kbps以上のMP3を使用します。ファイル形式よりも収録場所の静けさの方が重要です。録音後は速やかにP01_2026-05-15.mp3のように参加者コードと日付をファイル名に付け、個人情報を露出させることなく同意書と紐付けられるようにします。
フェーズ2:文字起こしレベルと表記ルールの策定
前述のセクションを参考に逐語レベルを決定し、最初のファイルを処理する前に1ページのスタイルガイドを作成します。
- 話者ラベル:すべての原稿で統一した形式(例:
Interviewer:、P03:) - 分析に必要な場合の沈黙マーカー:
[pause]、[long pause] - 非言語情報:
[laughs]、[sighs]、[becomes emotional] - 聞き取り不能な箇所:
[inaudible 23:45]、一部聞き取れる場合は[unclear: "助成金に関する何か"]とし、推測で埋めない - タイムスタンプ:話者交代ごと、または一定時間間隔ごと
インタビューの1〜10件目を素起こしにし、11〜20件目をケバ取りにしてしまうと、分析ソフトウェア上では同等のテキストとして処理され、分析の整合性が損なわれます。
フェーズ3:AIによる初稿の作成
ファイルを1つずつ処理するのではなく、話者ラベルを有効にしてまとめてアップロードします。インタビューの分析は「誰が何を言ったか」を正確に把握することに依存するため、話者の分離は不可欠です。仕組みと限界については、話者分離(ダイアライゼーション)の解説を参照してください。
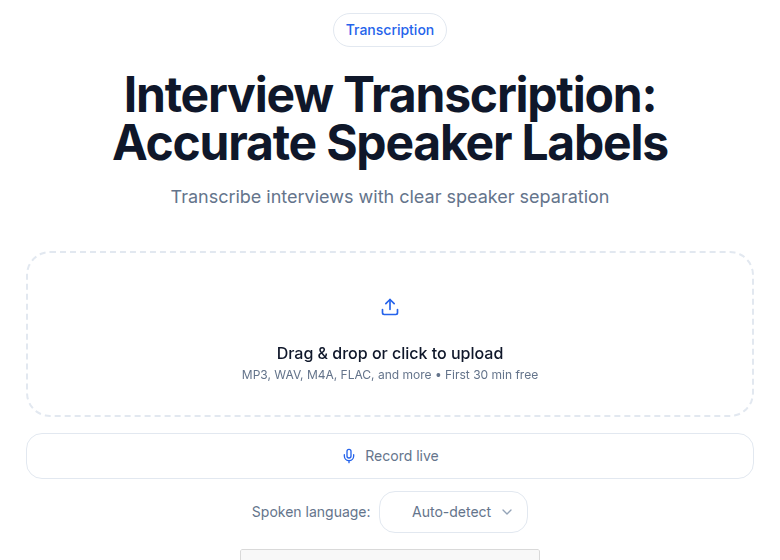 ConvertAudioToTextでのインタビュー文字起こしの様子
処理を行う前に、音声の言語を正しく設定してください。言語設定を誤ると精度が著しく低下します。60分のインタビューであれば、通常数分で文字起こしが完了します。静かな部屋でクリアに録音された音声なら精度は非常に高いですが、訛り、専門用語、発話の重複、感情が高ぶって小声になった箇所などでは精度が落ちます。現実的な精度については文字起こしの精度についてで詳しく解説しています。
フェーズ4:音声と照合した全文チェック
この段階は多くの研究者が過小評価しがちですが、ここを省くことはAIを活用した質的研究において最も陥りやすい方法論的ミスです。 音声を1.0〜1.25倍速で再生しながらテキストを読み、適宜修正していきます。特に以下の点に注意してください。
- 専門用語や特有の表現:参加者が自然に使っている専門分野の語彙。あらかじめ用語集を作成し、系統立てて修正します。
- 固有名詞:人名、組織名、地名、文化的レファレンスは、発音の似た別の言葉に誤変換されやすい傾向があります。
- 小声や感情的な発話:AIにとって最も聞き取りが難しく、かつ質的分析において最も重要な意味を持つことが多い箇所です。
- 発話の重なり:特にフォーカスグループでは、各発言を実際に誰が発したのかを注意深く確認します。
入念な確認作業には音声1時間あたり約1.5〜2.5時間かかりますが、ゼロから入力する4〜6時間に比べれば大幅に短縮されます。インタビュー20件ならおよそ60〜80時間の節約になります。複数人で確認を行う場合は、同じ15分間の区間を2名で個別にチェックして比較してみてください。差異が生じた箇所を確認することで、表記ルールをより明確に改善できます。
フォーカスグループ、講義、学位論文のコーパス
フォーカスグループの文字起こしは、複数人の発言が重なるため、1対1のインタビューよりも難易度が高くなります。テーブルの中央にマイクを置き、最初の発言時に全員に自分の識別コードを名乗ってもらうようにします。エディタ上で話者ラベルを参加者コードに一括変更すれば全行に反映されます。確認には通常より多めの時間を確保し、発話の重複箇所を重点的にチェックしてください。
研究用の講義文字起こし(授業観察や録画・録音されたセミナーなど)では、詳細な話者識別よりも、ケバ取りとタイムスタンプの正確さが重視されるのが一般的です。有料プランであれば長時間の録音にも対応しており、リンクや動画の処理なら1本あたり最大24時間まで扱えます。
博士論文の文字起こしでは、通常45〜75分のインタビューが20〜30件(合計15〜38時間の音声)に上ります。データの一貫性を保つため、コーパス全体を同一の設定と表記ルールで処理してください。
フェーズ5:別工程としての匿名化処理
オーラルヒストリーなど参加者が実名の記載を希望する場合を除き、ほとんどのプロトコルでは分析開始前の個人特定情報の除去(脱識別化)が義務付けられています。
完全な匿名化(Anonymization)と仮名化(Pseudonymization)は異なります。 匿名化は識別情報を恒久的に削除するもので、GDPR上、完全に匿名化されたデータは個人データとはみなされなくなります。一方、仮名化は識別情報をコード(「P04」や「山田」など)に置き換えつつ、対応表を保持する形式であり、規制の対象であり続けます。質的研究の多くでは仮名化が採用されます。
以下の情報を置換または改変します。
- フルネーム(参加者本人のほか、発言に登場する人物も含む)
- 住所、具体的な組織名、特定につながる地名
- 文脈から個人が特定できてしまうような固有の役職名
- 他の情報と組み合わせることで個人を絞り込める日付
- 参加者からオフレコを求められた内容
何を何に置き換えたかを記録する匿名化ログを作成し、文字起こしテキストとは別の場所に保管します。音声照合と同時に匿名化を行うよりも、独立した工程として実施する方が、精度の確認とプライバシーリスクの精査に意識を集中できるため確実です。より広範なコンプライアンスについては、インタビュー文字起こしの研究倫理を参照してください。
フェーズ6:NVivo、MAXQDA、ATLAS.tiへのインポート
これら3つの主要ソフトウェアはいずれもプレーンテキストおよびDOCX形式のインポートに対応しており、プロジェクト途中で移行が必要になった場合でもREFI-QDA(.qdpx)形式を介してプロジェクト全体を受け渡すことができます。アップロード時に使用したファイル名をそのまま維持し、まとめてインポートしてください。話者ラベルの形式を統一しておけば、話者ごとの自動コーディングがスムーズに行えます。なお、NVivoは独自の文字起こしアドオンも提供しています。両アプローチの比較については、NVivoとAI文字起こしの比較ガイドをご覧ください。
フェーズ7:規定に沿った保管と保存期間
倫理委員会(IRB)は、録音データ、文字起こしテキスト、同意書をどのくらいの期間保管し、どのような方法で破棄するかの文書化された計画を求めます。米国の多くの研究機関では研究終了後最低3年間の保管を定めており、公的助成金の場合はさらに長期が指定されることもあります。録音データには生の声が含まれるため匿名化テキストよりも漏洩リスクが高く、文字起こしの照合が完了した時点で音声を削除するよう推奨する倫理委員会も少なくありません。
- 保管データを暗号化し、研究チーム内のみにアクセスを制限する。
- 個人所有の端末ではなく、所属機関のサーバーや研究用途基準を満たすクラウドサービスを利用する。
- 個人特定可能なデータと脱識別化済みデータを分離する。
- 保管場所、アクセス権者リスト、保存スケジュール、破棄方法を倫理審査申請書に明記する。
AI文字起こしサービスを利用する際は、処理後に音声が保持されるか、その期間はどれくらいか、入力データがAIモデルの学習に使用されるか、処理が行われるリージョン、データ処理契約(DPA)が締結可能かなどを確認し、申請書に記載してください。
ConvertAudioToTextに関して申請書に記載できる事実: 通信時(TLS 1.2以上)および保存時(AES-256)に暗号化されます。ユーザーのコンテンツを人間が閲覧することはありません。無料プランでは処理完了の通常約7日後に元音声が自動削除されます。有料プランでは音声の保持期間を任意に設定できます(7日、30日、90日、180日、1年、または無期限)。文字起こしテキストはユーザーが明示的に削除するまでアカウント内に残ります。ConvertAudioToTextはSOC 2認証を取得しておらず、BAA(医療データに関する契約)は標準付帯ではなく個別相談となります。詳細はセキュリティページおよび下請処理者リストに記載されています。
学位論文のインタビュー文字起こしにかかる費用
約1時間のインタビュー25件(合計25時間の音声)を処理する場合の比較です。
| 手法 | 金銭的コスト | 所要時間 |
|---|---|---|
| 自力での手入力 | 0ドル | 100〜150時間 |
| 人手による文字起こし業者(Rev:1分1.99ドル) | 約2,985ドル | 抜き取り確認のみ |
| AI下書き + 自ら確認(ConvertAudioToText Pro) | 1か月あたり$14.99 | 38〜63時間の確認時間 |
| AI下書き + 自ら確認(Weekly Pass) | 1パスあたり$9.99(1,200分、7日間利用可)、25時間なら2パス分 | 38〜63時間の確認時間 |
Revの人手による文字起こし価格はrev.com/pricingより(2026年10月14日確認)。
多くの研究者がハイブリッド方式を採用しています。大半のインタビューにはAIを利用し、音質が極端に悪い3〜4件や特に重要な録音のみ人手による専門サービスに委託するという使い分けです。なお、Proプランで30日間に約30時間を超えるような非常に多い利用を行う場合、標準エンジンで処理されることがあります。料金の全体像については、文字起こしの時間あたり費用を参照してください。
取り入れるべき品質確認プロセス
メンバーチェッキング(Member checking): LincolnとGubaによる1985年の信頼性(trustworthiness)フレームワークでは、作成した文字起こしを参加者に戻して確認してもらうことを信憑性を高める手法として挙げています。現象学やグラウンデッド・セオリーでは一般的ですが、会話分析ではあまり行われません。
監査証跡(Audit trail): 使用したツール、各原稿を確認した作業者、採用した表記ルール、聞き取りにくい箇所における判断基準を詳細に記録しておきます。
分析全体に悪影響を及ぼす3大ミス
AIの文字起こし結果を原本(正本)として扱ってしまうこと: 原本はあくまで録音音声です。引用箇所に含まれる単語の誤認識が誤ったコードを生み、最終的に誤ったテーマの導出につながります。
プロジェクト内で表記ルールが統一されていないこと: 最初のファイルを処理する前にルールを決定し、すべての文字起こしで厳密に適用してください。
匿名化の省略: 実名が残ったままの原稿を共有ストレージに置いたり、指導教員に送信したり、未修正のままアーカイブに登録したりすると、同意条件違反となり、GDPRや倫理委員会のプロトコル違反につながる恐れがあります。
まずは試してみる
アカウント登録なしでインタビューの最初の30分間を無料で文字起こしし、実際の録音の仕上がりを確認できます。無料アカウントを作成すると、1回あたり最大30分のファイルを1日30件まで、話者ラベル付き・TXT形式で文字起こしでき、最初の1ファイルは最大1時間までDOCX形式でのエクスポートも可能です。長時間のインタビューの全文処理や多様な出力形式が必要な場合は、Weekly PassまたはProプランでコーパス全体をカバーできます。研究者向けの詳細情報はアカデミア向けページもご覧ください。
FAQ
研究インタビューを文字起こしする最適な方法は何ですか?
話者ラベル付きのAI下書きを作成し、コーディングを始める前に音声と照合して確認します。事前に逐語レベルを決定し、すべての原稿で同じ表記ルールを用い、別工程として匿名化を実施します。未確認のAI文字起こしは単なる下書きであり、データではありません。
ケバ取り(intelligent verbatim)文字起こしとは何ですか?
ケバ取り(クリーンバーバティム)とは、話者の発言内容や意味をすべて維持しつつ、フィラー(「えーと」「あの」など)、言い淀み、重複を削除し、読みやすさのために文法を軽く整える手法です。主題分析、内容分析、グラウンデッド・セオリーなどで標準的に選ばれます。一方、素起こしはあらゆるフィラー、沈黙、重複を記録するため、会話分析や談話分析に必要とされます。
質的研究にAI文字起こしを使用できますか?
はい、人間による確認工程を必須とすれば使用できます。AIは60分のインタビューから実用的な下書きを数分で作成します。クリアな音声での精度は高いですが、発言の重複、訛り、現場のノイズ、小声や感情的な発声では精度が落ちます。論文等に引用する箇所は必ず録音と照合して確認してください。
1時間のインタビューの文字起こしにはどれくらい時間がかかりますか?
自分でゼロから手入力する場合、通常4〜6時間かかります。AIの初稿がある場合、音声と照合した入念な確認作業は音声1時間あたり約1.5〜2.5時間で済み、クリアな録音ならさらに短縮できます。
フォーカスグループの文字起こしはどのように行えばよいですか?
テーブルの中央にマイクを置き、参加者には発言冒頭で名前や識別コードを名乗ってもらい、話者ラベルで声を区別します。参加者同士の発言が重なり合うため、1対1のインタビューよりも確認に時間がかかります。エディタ上で話者ラベルを参加者コードに一括変換し、発言の重複箇所を音声と照合してください。
方法論セクションでAI文字起こしの使用をどのように開示すべきですか?
初稿の作成にAI文字起こしソフトウェアを使用し、研究チームが元の音声と照合してすべての原稿を確認・修正した旨を記述します。ジャーナルや倫理審査委員会(IRB)によっては、AIツールが参加者データをどのように扱ったかの説明を求める場合があるため、所属機関の最新のガイドラインに従い、要求に応じてツール名を明記してください。
分析の前に文字起こしテキストを匿名化する必要がありますか?
通常は必要です。参加者を特定し得る氏名、地名、勤務先、日付、固有の情報を置き換える作業を、記録を残しながら独立した工程として実施します。仮名と実際の身元を紐付ける対応表は文字起こしデータとは切り離し、アクセス制限をかけて保管してください。
AI文字起こしテキストに対応しているQDAソフトウェアは何ですか?
NVivo、MAXQDA、ATLAS.tiはいずれもプレーンテキストおよびDOCX形式の文字起こしデータのインポートに対応しており、REFI-QDA(.qdpx)形式を介してプロジェクト全体の相互移行も可能です。所属機関がライセンスを持つものや、採用する研究手法に適したものを選択してください。
インタビューの録音と文字起こしデータはどのくらいの期間保管すべきですか?
米国の多くの研究機関では研究完了後最低3年間のデータ保管を定めており、助成機関によってはさらに長期の保管が求められます。音声録音は匿名化されたテキストよりもリスクが高いため、文字起こしの正確性が確認された段階で音声を削除することを推奨する倫理委員会も多くあります。IRBプロトコル、助成機関の条件、所属機関の規定に従ってください。
参考文献・情報源
- Rev料金表:人手による文字起こし 1分1.99ドル(2026年10月14日確認)
- ペンシルベニア州立大学 IRB ガイドライン XI、音声・映像・デジタル記録を含む研究:https://researchsupport.psu.edu/orp/irb/irb-resources-training-and-events/irb-guidelines/irb-guideline-xi-research-involving-audio-video-or-digital-recordings-of-research-participants/
- フロリダ大学 IRB、研究データ保持に関する研究者要件:https://irb.ufl.edu/index/data/investigator-requirements-for-retaining-research-data.html
- Braun and Clarke 反省的主題分析の概要:https://www.maxqda.com/research-guides/thematic-analysis
- グラウンデッド・セオリー手法の系譜とコーディング手法:https://pmc.ncbi.nlm.nih.gov/articles/PMC6318722/
- ジェファーソン式文字起こし体系の解説:https://universitytranscriptions.co.uk/jefferson-transcription-system-a-guide-to-the-symbols/
- REFI-QDA形式とQDAソフトウェアの相互運用性:https://www.quirkos.com/learn-qualitative/refi-qda-exchange-atlasti-nvivo-maxqda.html
- ATLAS.ti、質的研究におけるデータ匿名化:https://atlasti.com/research-hub/data-anonymization-qualitative-research
- Statistics Solutions、質的研究におけるメンバーチェッキング:https://www.statisticssolutions.com/member-checking-in-qualitative-research/
- ConvertAudioToText セキュリティ:暗号化、データ保持、認証に関する仕様
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
Spotifyポッドキャストの文字起こし:テキストの取得・コピー・ダウンロードを無料で行う方法
Spotifyポッドキャストを無料で文字起こしする方法:公式機能で十分なケース、YouTubeやRSSを活用するルート、エピソードのリンクを貼り付けてコピーやダウンロード可能なテキストを取得する方法を解説。
臨床記録向け医療文字起こし:臨床医のための実践的AIワークフロー
臨床医がカルテや臨床記録にAI文字起こしを活用する方法を解説。音声アップロード、話者識別、要約作成、TXTやDOCXへのエクスポートを含むCATTの実践的ワークフローを紹介します。