リアルタイム翻訳の未来、実際に来るもの
Summarize this article with:
実際に来ているもの
サブ秒単位のリアルタイム音声翻訳は、2027年の約束事ではない。2026年に実装された。OpenAIのGPT-Realtime-Translateは、70の入力言語に対してエンドツーエンドの遅延が400〜900ミリ秒で、話者が話している最中に翻訳済み音声をストリーミング配信する。問題は「いつライブ感を味わえるほど速くなるのか」から、「どのユースケースが本番で信頼できて、どれがまだ恥をかくのか」に変わった。
この投稿では、検証可能な形で進んでいる軌道を整理し、ベンダーがデモで見せるが実世界では維持できない主張と切り分ける。今日使えるツールの調査は、リアルタイム翻訳ツールのまとめを参照してほしい。この投稿は、この分野が何を目指して構築されているかを扱う。
3つのタイプは、まだ成熟度が異なる
最も信頼性の高いリアルタイム翻訳の形は、別言語への音声テキスト化、つまり英語で話してスペイン語で文字起こしされることだ。これは数年前から本番運用が可能だった。Whisperの翻訳モード、Deepgramの組み込み翻訳エンドポイント、Azure Cognitive Servicesは、主要な言語ペアでクリーンな音声に対して90%台の精度を処理する。遅延はオフラインモデルで2〜4秒、ストリーミングアーキテクチャでは1秒未満だ。実践的な手順は、音声翻訳のワークフローガイドでカバーしている。
一段難しいのが、一方向の音声から音声への変換です。話すと、システムが目標言語の合成音声を出力します。MetaのSeamlessファミリー(2023年後半に公開され、その後改良が続く)と、GoogleのTranslatotron 3研究モデル(2023年12月に発表)は、どちらもこの課題に取り組んでいます。Seamlessは韻律と感情を保持し、Translatotron 3は並行音声コーパスなしで単言語データから学習する研究用アーキテクチャで、低リソース言語への拡張に重要な意味を持ちます。どちらもほとんどの開発者にとってすぐに使える商用製品ではありませんが、他のベンダーが目指す上限を設定しています。
最も難しいのが、双方向の会話です。両方の話者がそれぞれの言語で相手の声を聞く形です。GPT-Realtime-Translateは、これを開発者にとって本当に手が届きやすいものにした最初の本番APIで、音声1分あたり0.034ドルです。会話には、システムが発話の終わりを捉え、翻訳し、合成する間の固有のポーズがまだありますが、対応言語ペアと良好なネットワーク環境では、往復全体が1秒未満に収まります。これは、2024年の4秒から7秒の往復時間からの、本当の閾値の変化です。
現在のシステムが実際に壊れる箇所
失敗のパターンはベンダー間で一貫しており、ベンダーがそれを明確に宣伝することはほとんどありません。
低リソース言語は、最も予測可能な失敗要因のままです。主要なヨーロッパ言語と東アジア言語のペアでは、クリーンな音声での単語誤り率は8〜12パーセントです。トレーニングデータが限られたアフリカや東南アジアの言語では、AI翻訳のスコアは人間の品質ベンチマークの平均50〜65パーセントです。GPT-Realtime-Translateは70の入力言語をサポートしますが、出力言語は13のみで、すべて高リソース言語です。Whisper Large-v3は紙面上99言語をカバーしますが、ロングテールの精度はトップ10より大幅に劣ります。
グローバルなオーディエンス向けの製品を作っているなら、「X言語対応」が全言語で同等の品質を意味すると思い込まないこと。ベンダーに決める前に、実際のターゲット言語ペアで現実的な録音を使ってテストしよう。
コードスイッチングは、まだ大規模には解決されていない。文の途中で言語を混ぜるバイリンガル話者は、単一言語または厳密に分離されたバイリンガルデータで訓練されたほとんどのパイプラインを壊してしまう。コードスイッチングの回避策に関する投稿では、現在利用可能な実用的な緩和策を扱っている。
文化的・慣用的な翻訳品質は、訓練データがどうだったかに大きく依存する。主に議会記録や技術マニュアルで訓練されたモデルは、慣用句、ジョーク、文化特有の言い回しをうまく扱えない。これはレイテンシやモデルサイズの問題ではない。データの問題であり、発表されたどのモデルも完全には解決していない。
マルチスピーカー対応には厳しい上限がある。DeepL Voice、KUDO AI、Interprefy Aiviaはすべて、1対1の会話をうまく処理する。しかし、3人目や4人目の話者が加わると、システムは誰がどの言語で話しているかを同時に追跡し、翻訳出力を正しい聞き手にルーティングしなければならない。エンタープライズ導入の現場レポートによると、本番システムは今でもスムーズな結果を得るために同時話者2人前後で頭打ちになっている。
2027年までに実際に来るもの
根拠のある予測のみ: これらの各項目は、すでに進行中で検証可能な開発に遡れる。
オンデバイス翻訳の拡大
Fragment 4:
Appleは2025年9月、Apple Intelligenceの一部としてライブ翻訳をリリースしました。Messages、FaceTime、電話通話で、8から17言語を端末上で処理します。Googleは最近のAndroidアップデートにオフラインのライブ翻訳コードを組み込んでいますが、出荷日は未確認です。個々の言語パックは50から150 MBなので、カバレッジを広げるのはモデルサイズの問題というより、配布とライセンスの問題です。その軌道からすると、2027年までに主要な20の言語ペアで端末上翻訳が実現するのは妥当です。プライバシー重視の文脈(法務、医療、政府)では、カバレッジ拡大に伴い端末上処理への移行が進むでしょう。
商用吹き替えにおける声の保存
HeyGenとElevenLabsはどちらも、話者の元の声の特徴をターゲット言語で保持する吹き替え動画を提供しています。HeyGenは5つのテスト言語でピッチとテンポの一致を報告しており、エラー率は5パーセント未満です。ElevenLabsのDubbing V2は90以上の言語に対応し、感情の抑揚を保持します。DeepL Voiceはエンタープライズ製品向けの声保存機能を発表しており、2026年末のリリースを目指しています。
これはライブ会話より先に録画動画で実現しています。理由は明白で、録画コンテンツは翻訳を合成する前にシステムが声をクローンする時間を確保できるからです。ライブ通話でのリアルタイム声保存翻訳はまだ研究段階です。エンターテインメントとコンテンツ制作では2026年から2027年にかけて広く展開され、ライブ会話での声クローンはその後1年から2年で続くと予想されます。
ストリーミングアーキテクチャが標準になる
レイテンシー改善の大半を牽引するアーキテクチャ上の変化は、モデル単体の改良ではありません。すべての段階でのストリーミングです。ストリーミングASR、並行実行される非同期パイプライン段階、ストリーミングTTSです。あるベンチマークでは、オフラインからストリーミングASRへの切り替えで、60秒の入力に対するレイテンシーが約9倍短縮されました。オフラインからストリーミングTTSへの切り替えでは、総レイテンシーが4,200 msから475 msに低下しました。
2027年までに、バッチ処理に基づく本番向けリアルタイム翻訳製品は競争上の不利を免れない。ストリーミングアーキテクチャは、ライブ会話レイテンシーを謳うあらゆる製品にとって、すでに必須の基準となっている。
高リスクな現場では、人間の支援が残る
現在の現場報告によると、AI同時通訳は主要言語間の一般的なビジネス会話において、人間の品質の90〜95パーセントに達している。専門用語を含む医療・法務コンテンツでは、カスタム語彙によってその差は縮まるものの、責任の枠組みは変わっていない。米国の医療提供者は、Affordable Care Act第1557条に基づき、資格を持つ通訳者を提供することが義務付けられている。公民権局は2026年向けに罰則の段階を更新し、故意の怠慢に対する罰金は1件あたり7万1,000ドルを超える。
おそらくその軌道はこうだ。AI翻訳は、高リスクな現場で人間の通訳を完全に置き換える前に、リアルタイムの支援ツール(用語のプロンプト、文脈の要約、自動メモ)として機能する。このハイブリッド型は、Interprefyなどのベンダーからすでに商用提供されている。
開発者と購入者への実践的ガイダンス
実際の問題を解決する、最もシンプルな翻訳の形を選ぶこと。他言語への音声認識は、音声から音声への翻訳よりはるかに正確で安価だ。ユーザーがキャプションや字幕を必要とするなら、音声合成は不要。多言語会議の文字起こしや字幕翻訳ワークフローには、テキストのみの経路が正しい出発点となる。
ベンダーのデモではなく、実際の音声でテストすること。デモはクリーンな音声、準備された話者、ベンダーが最も得意とする言語ペアを使う。ユーザーには背景ノイズ、アクセント、早口、専門用語がある。ベンダー契約を結ぶ前に、プライベートパイロットを実施しよう。
Fragment 6:
回避できない障害モードに備えた計画を立てる。コードスイッチング、低リソース言語、複数人数の会話は2026年でもエラーを生む。「失敗するか」ではなく「失敗したらどうなるか」が問題だ。優雅なフォールバックも製品の一部である。
今日、クリーンな文字起こしだけが必要で、ミーティングボットやリアルタイム合成レイヤーが不要なら、ConvertAudioToText はサインアップ不要で100以上の言語の音声ファイルや動画を処理する。
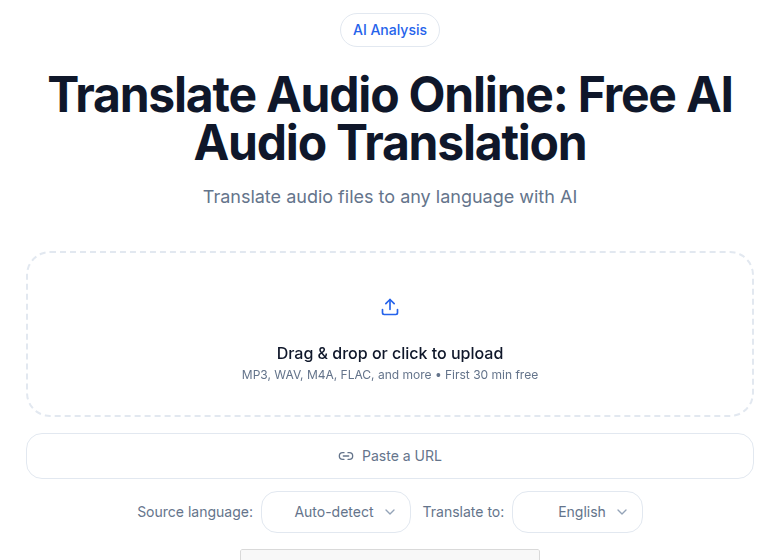 音声からテキストへのツールは自動検出を含む多言語アップロードを処理する
FAQ
リアルタイム音声翻訳は2026年に人間の通訳を置き換えられるほど優れているか?
主要言語間の一般的なビジネス会話では、AI通訳は現場の報告によると人間の品質のおよそ90〜95%に達する。専門性の高い内容(医療、法律、外交)や感情的なやり取りでは、人間の通訳が依然として勝る。また多くの法域では、医療現場で資格を持つ人間の通訳を法的に義務付けている。2026年の実用的な答えは、AIは最初の下訳や低リスクな場面で有効であり、高リスクな文脈では人間が不可欠だということだ。
今日のリアルタイム翻訳の実際の遅延はどのくらいか?
アーキテクチャと翻訳の種類によって異なる。OpenAIのGPT-Realtime-Translateは、70の入力言語に対して音声から音声までのエンドツーエンドで400〜900ミリ秒を実現している。Meta SeamlessM4T-v2は論文のベンチマークで300〜600ミリ秒を示すが、本番環境では800〜1,500ミリ秒になる。重要なユーザー体験の閾値は、800ミリ秒未満ならライブ感があり、2秒を超えると話者が翻訳に被せて話し始める。
2026年に信頼できるリアルタイム翻訳を提供する言語はどれか?
主要な言語ペア、特に英語とスペイン語、フランス語、ドイツ語、中国語(マンダリン)、日本語、韓国語の間では、クリーンな音声でワードエラー率が8〜12パーセントに達します。低リソース言語、特にアフリカの大半と東南アジアの多くの言語は、平均して人間の品質スコアの50〜65パーセントを記録します。翻訳品質はそれらのペアでさらに低下します。音声認識モデルと翻訳モデルの両方が、より少ないデータで訓練されているからです。
音声クローンと翻訳の組み合わせは、実際に本番環境で提供されるのでしょうか?
すでに限定的な形で実現しています。HeyGenとElevenLabsはどちらも、90〜175言語にわたって話者の声の特徴を保持した吹き替え動画を提供しており、HeyGenはテストでピッチとテンポが5パーセント未満のエラー率で維持されると主張しています。DeepL Voiceは、エンタープライズ製品向けの音声保持機能を発表しており、2026年末までのリリースを目指しています。エンターテインメントやコンテンツ制作のユースケースは現在展開中で、消費者向けアプリでのリアルタイム会話型音声クローンはまだ研究段階にあります。
出典
- 2026年のリアルタイム音声翻訳ベンダー4社比較(2026年7月確認)
- リアルタイム音声間翻訳アーキテクチャガイド(2026年7月確認)
- シームレスなコミュニケーション:MetaのAI(2026年7月確認)
- Google AI、Translatotron 3を発表(2026年7月確認)
- GPT-Realtime-Translateモデル(2026年7月確認)
- DeepL Voice:グローバルチーム向けの即時・安全な音声翻訳(2026年7月確認)
- Appleのオンデバイスライブ翻訳:その重要性とは?(2026年7月確認)
- HeyGen vs ElevenLabs vs Rask AI vs Dubverse:2026年最強のAI吹き替えツール(2026年7月確認)
- ElevenLabs吹き替えドキュメント(2026年7月確認)
- 2026年のAI翻訳精度率(2026年7月確認)
- 通訳におけるAI:2026年のリモートサービス(2026年7月確認)
Try transcription free
Convert any audio or video to clean, unwatermarked text — speaker labels, timestamps, and AI summaries included. First 30 minutes free, no account.
Related Articles
How to Transcribe Voice Recorder Recordings (Any Device)
Get text from any voice recorder, from Anker SoundCore Work to old Olympus dictaphones. Covers file transfer, formats, WMA conversion, speaker labels, and export options.
Draft a Follow-Up Email From a Meeting With AI (2026)
Turn any meeting recording into a polished follow-up email in under five minutes. Prompt templates, edit checklist, and privacy guidance for AI-drafted meeting emails.